最近、Codexを使っていて、残りの利用枠が以前ほど速く減らなくなったと感じませんか。私も、GPT-6 Solが登場したころから、残量の減り方がずいぶん緩やかになったように感じています。
そこで気になったのが、「使用量を節約したいなら、古いモデルに戻したほうがよいのか」ということです。最新モデルは高性能なぶん消費も大きく、少し前のモデルなら長く使える。そう考えたくなりますが、いまのCodexでは、その選び方が必ずしも合理的とは限りません。
今回比較するSolは、新しいモデルのほうが処理単価が安く、仕事を完成させるまでの効率もよくなっている可能性があるからです。 一方、既存Pro 200の利用枠には、2026年10月30日からの変更が予告されています。モデルの進化と、プランの変更。この2つを分けると、いま感じている使いやすさと、これからのモデル選びが見えてきます。[1][2][16]
情報確認日:2026年10月5日。以下では、主にGPT-5.6 Sol・GPT-6 Sol・GPT-6.1 Solを比較します。
「旧モデルほど安い」とは限らない。Solの料金は世代交代で下がった
まず、公式情報で確認できる変化から見ていきます。OpenAIは2026年9月22日にGPT-6 Sol、9月29日にGPT-6.1 Solを発表しました。日付はOpenAIの公式発表一覧に基づきます。[3]
GPT-5.6 Solより、6/6.1 Solのほうが低い単価
モデルの処理量は、文章などを細かく分けた「トークン」という単位で数えます。通常の入力、再利用できるキャッシュ済み入力、生成する出力では、それぞれ単価が異なります。
以下は、外部のアプリなどからモデルを呼び出し、使った分に応じて支払うAPIの標準料金です。Codexの月額プランで表示される残量%の換算表ではありません。比較条件はStandard、入力が272,000トークン以下の場合で、単位は100万トークン当たりの米ドルです。[5][6][7]
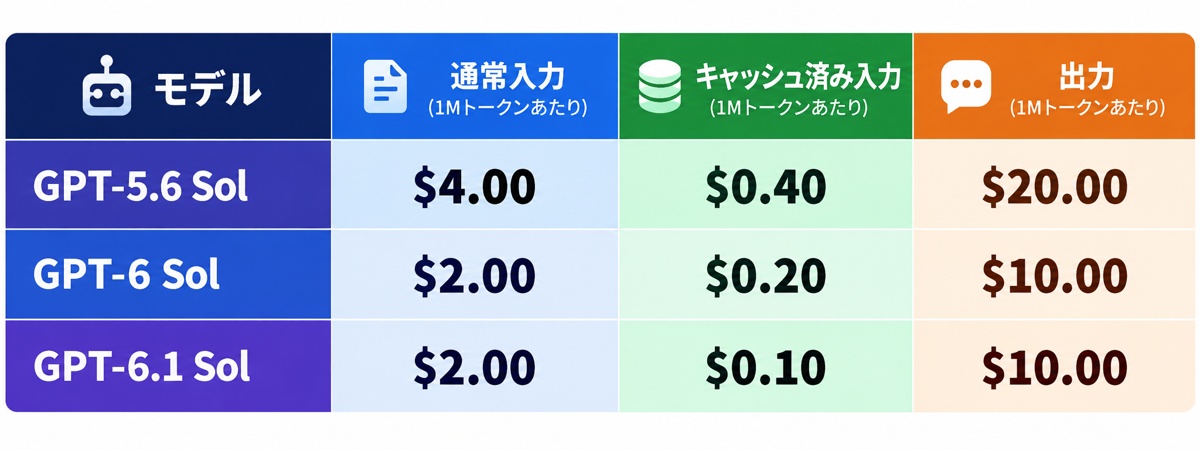
GPT-5.6 Solは、少なくとも2026年11月21日まで提供予定のプロモーション料金です。APIのキャッシュ書き込み、ツールなどの追加料金は上表に含めていません。[5][7]
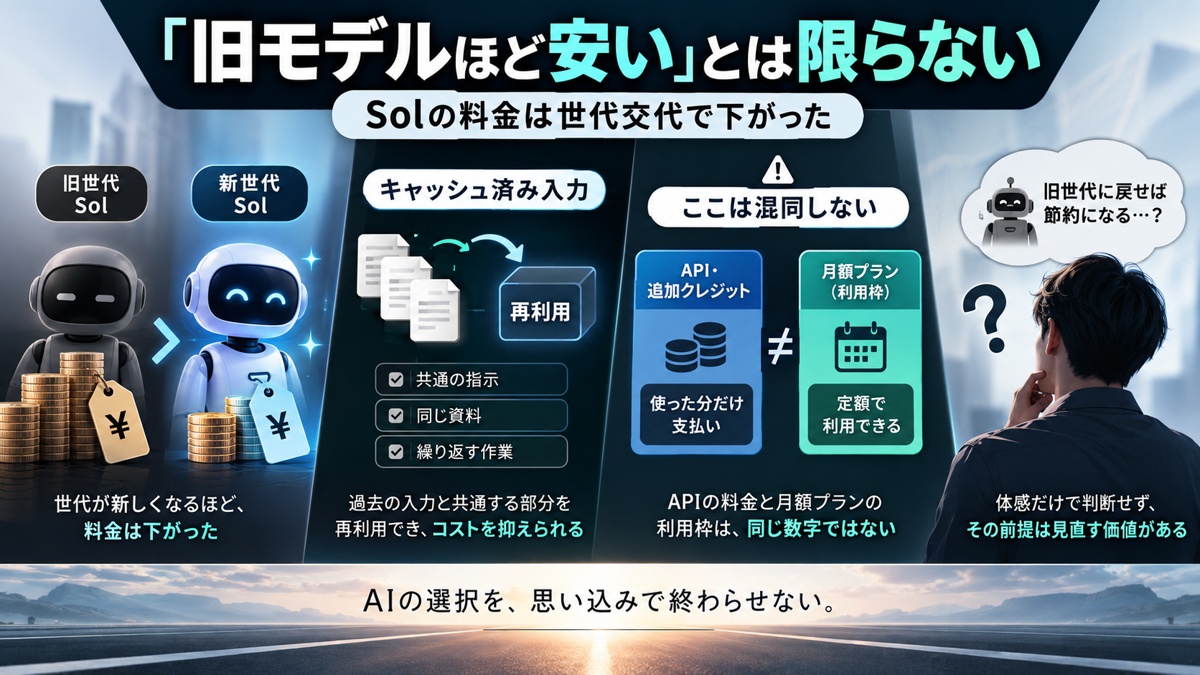
同じ種類・同じ量のトークンなら、6.1 Solの通常入力と出力は5.6 Solの半額、キャッシュ済み入力は4分の1です。 旧モデルのほうが安いどころか、この比較では新モデルのほうが安くなっています。
6 Solから6.1 Solへの変化は、通常入力・出力の据え置きと、キャッシュ済み入力の半額化です。「6.1になって、すべての処理がさらに半額になった」という意味ではありません。[6][7]
繰り返し使う文脈も、効率化の対象になっている
キャッシュ済み入力とは、過去の入力と共通する部分について、処理結果を再利用できる入力のことです。毎回共通の指示や資料を扱う作業では、この再利用がコストを左右します。
GPT-6では、キャッシュが使われる割合を高める改善も発表されています。6.1では、そのキャッシュ済み入力の単価がさらに下がりました。単に「新しいモデルを追加した」だけでなく、継続的にエージェントを動かす際の効率も改善する方向です。[4][7]
ただし、長い会話を続ければ、すべての入力が自動的に安くなるわけではありません。実際に再利用できる部分がどれだけあるかによって、恩恵は変わります。[4]
APIの半額と、月額プランの消費半減は別の話
ここは混同したくないポイントです。APIや追加クレジットの料金と、月額プランに含まれる利用枠は、同じ数字ではありません。
実際、2026年8月のGPT-5.6 Solの値下げでは、OpenAIはAPI・クレジット料金を引き下げる一方、Pro・Plus・Businessのサブスクリプションでの使用量の扱いは変わらないと説明していました。価格表だけを見て「Codexの残量も必ず半分しか減らない」と判断することはできません。[8]
一方、月額プラン側の現行の公式目安にも、参考になる情報があります。PlusとBusiness Standardのローカルメッセージ数は、5時間当たりで次のように案内されています。[9]
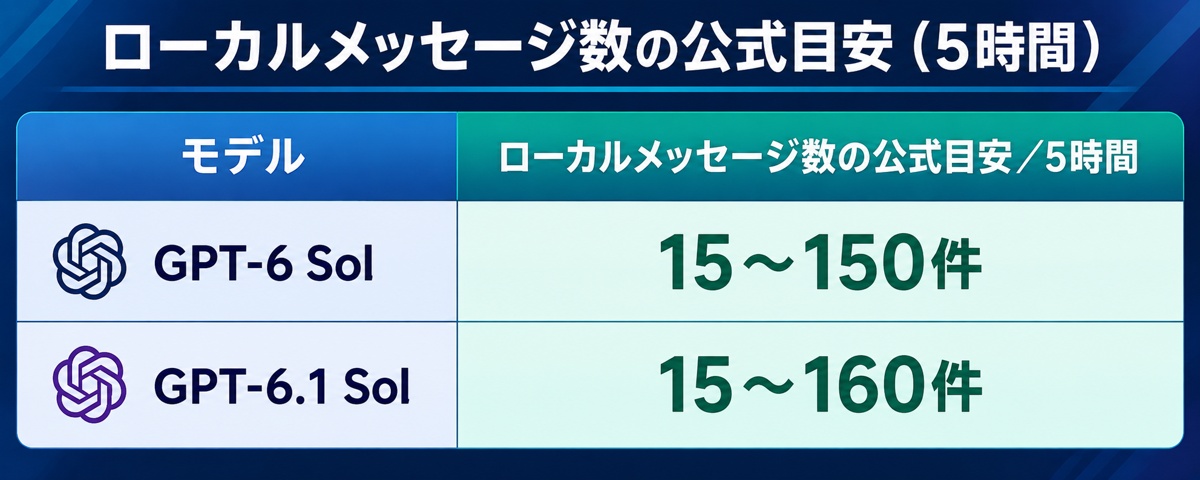
これは保証された回数でも、x-high限定の比較でもなく、Pro 200の週次枠へそのまま換算できる数字でもありません。それでも、「6.1は最新だから、6より利用枠を大きく消費するはず」と考える必要はないことが分かります。[9]
私の体感だけで改善率を決めることはできませんが、「旧世代のSolに戻せば節約になる」という前提は、見直す価値があります。
x-high同士でも、使用量の減り方が同じになるわけではない
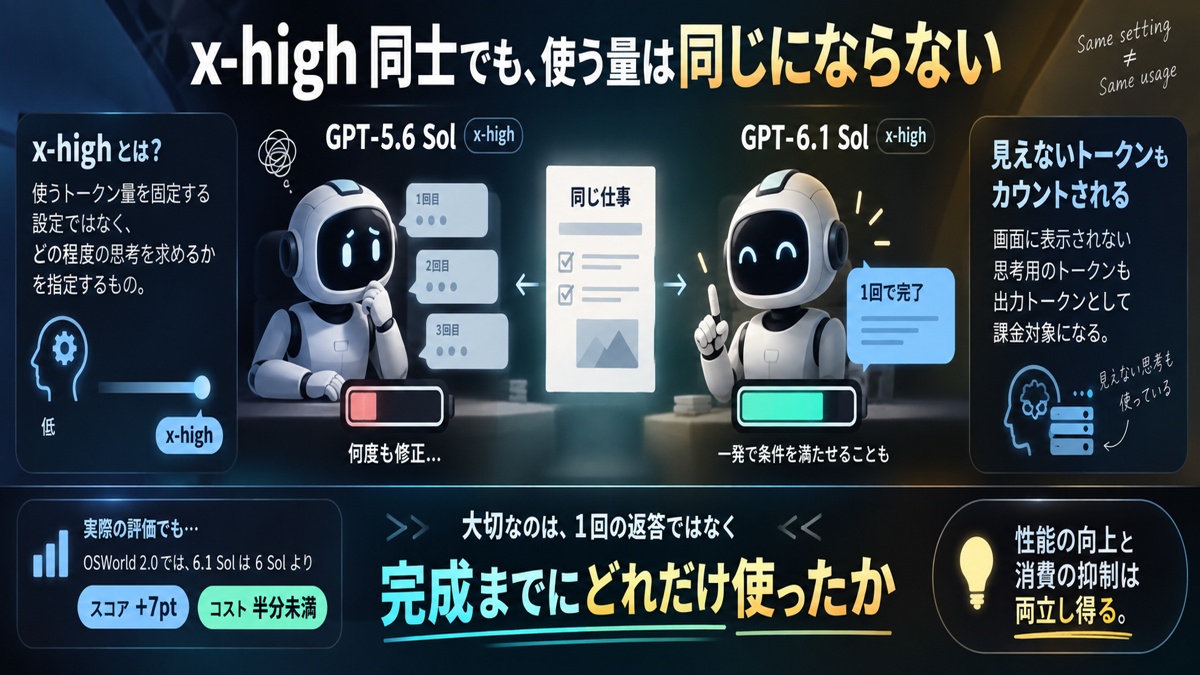
では、「GPT-5.6 Solのx-high」と「GPT-6.1 Solのx-high」を比べたら、消費はどのくらい違うのでしょうか。
この組み合わせで、同じ仕事を完成させるまでの残量%を測った結果は、今回の記事にはありません。ただし、比較する際に押さえておきたい仕組みはあります。
x-highは、一定量のトークンを使う設定ではない
x-highは、モデルにどの程度の思考を求めるかを指定する設定です。「必ず何トークン考える」「残量を何%使う」という固定量の指定ではありません。OpenAIも、推論の設定は作業ごとの消費量を固定せず、高くすれば必ずよい結果になるわけでもないと説明しています。[9]
さらに、APIでは、最終回答に表示されない思考用のトークンも出力トークンとして課金対象になります。画面に出てきた回答が短くても、内部で多くの推論をしていれば、処理量が少ないとは限りません。[10]
つまり、両方をx-highにそろえても、同じ計算量になるわけではないのです。
比べたいのは、1回の返答ではなく「完成までの消費」
仮に、古いモデルでは修正を3回頼む必要があり、新しいモデルなら最初の回答で条件を満たせたとします。この場合、新モデルの1回当たりの処理量が多少多くても、完成までの総消費は小さくなる可能性があります。もちろん、これは仕組みを説明するための例で、実測結果ではありません。
公式の評価にも、「高性能なのに、作業当たりのコストが低い」という例があります。コンピューター操作を評価するOSWorld 2.0では、最大の推論設定で、6.1 Solは6 Solよりスコアが7ポイント高く、作業当たりのコストは半分未満でした。これはOpenAIの評価環境での結果であり、Codexのx-high同士の残量比較ではありません。[2]
それでも、性能の向上と、消費の抑制は両立し得ると分かります。「最新だから高消費」と決めつけるより、同じ品質の仕事を終えるまでにどれだけ使ったかで考えるほうが、実用に合っています。
いまは6.1 Solを基本に、作業に合わせて設定を選ぶ
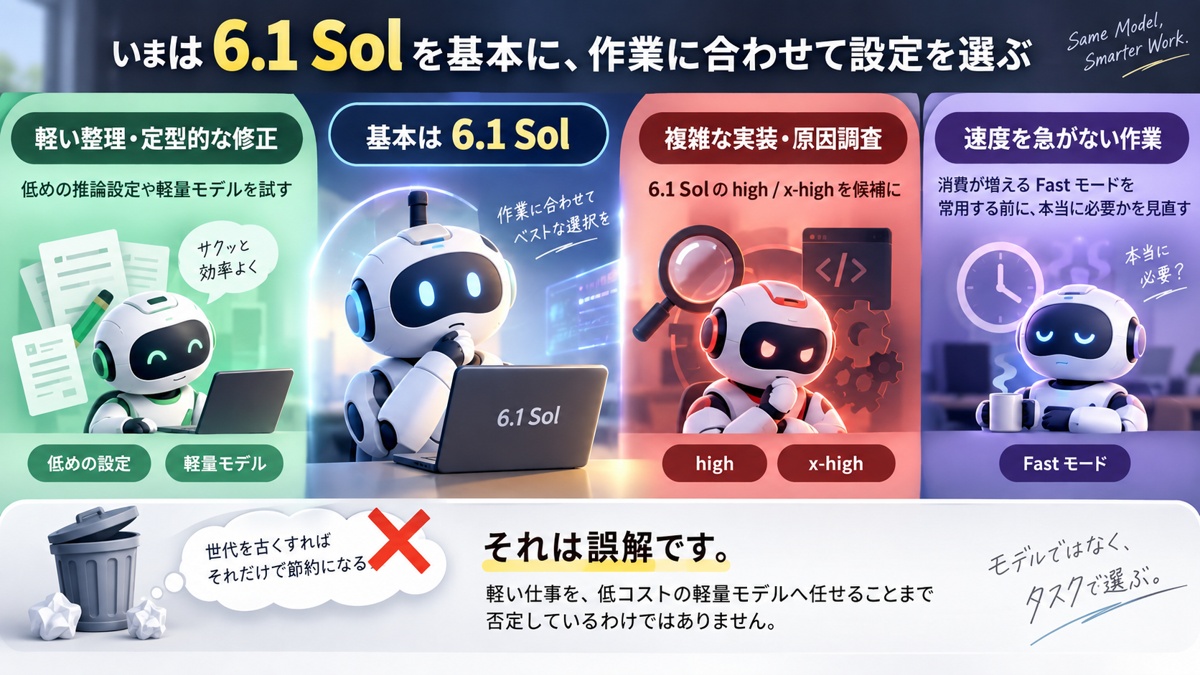
5.6 Sol・6 Sol・6.1 Solから普段使いを選ぶなら、私は6.1 Solを第一候補にするという考えです。公開単価と性能改善の両方を見ると、「最新だから使用量が心配」という理由だけで、5.6 Solへ戻す積極的な理由は見当たりません。[5][7][2]
ただし、「6.1 Solを基本にする」と「何でもx-highで実行する」は別の判断です。
節約するなら、まず思考の強さと作業範囲を見る
単純な表記修正と、原因が分からない不具合の調査では、必要な考え込み方が違います。次のように使い分けると、性能を落とすことだけに頼らず、消費を見直せます。
- 複雑な実装や原因調査では、6.1 Solのhigh/x-highを候補にする。
- 軽い整理や定型的な修正では、6.1 Solの低めの推論設定や、軽量モデルを試す。
- 速度を急がない作業では、消費が増えるFastモードを常用する必要があるか見直す。
- 資料や指示が膨らんだ作業では、今回必要な範囲と、完成条件を絞る。
これは一律の最適設定ではなく、結果を見ながら調整するための方針です。公式ガイドも、作業範囲や不要な文脈を減らし、仕事に合ったモデル・推論設定を選ぶことを勧めています。[11][12]
Fastは、モデルの世代やx-highとは別の速度設定です。現行のPro向け公式ヘルプでは、同じモデルのStandardと比べ、Fastはプランに含まれる利用枠を2.5倍の率で消費すると説明されています。APIのFast料金とは別の数字です。古いモデルをFast、新しいモデルをStandardで比べると、モデルの違いと速度設定の違いが混ざってしまいます。[15]
「古いモデル」と「軽量モデル」を一緒にしない
今回見直したいのは、世代を古くすれば、それだけで節約になるという考え方です。軽い仕事を、低コストの軽量モデルへ任せることまで否定しているわけではありません。
例えばGPT-6 Lunaは、定型的で件数の多い作業向けのモデルです。難しい仕事まで無理に軽量モデルへ押し込む必要はありませんが、情報の分類や短い編集など、必要な品質を満たせる仕事では選択肢になります。[14]
また、この記事の「新しいSolを使う」という話は、別の上位モデルであるGPT-6 Astraを、すべての作業で選ぶという意味でもありません。モデル名の数字だけでなく、用途と料金の階層まで見ることが大切です。[2]
「最新モデル一択」と固定するより、Solを使う仕事は6.1から検討し、軽い仕事は設定やモデルを軽くする。旧モデルへ戻すのは、自分の仕事で明確な利点が確認できたとき。いまは、その順番が合理的だと考えています。
5.6と6.1の消費を比べるなら、同じ仕事の「完成まで」を測る
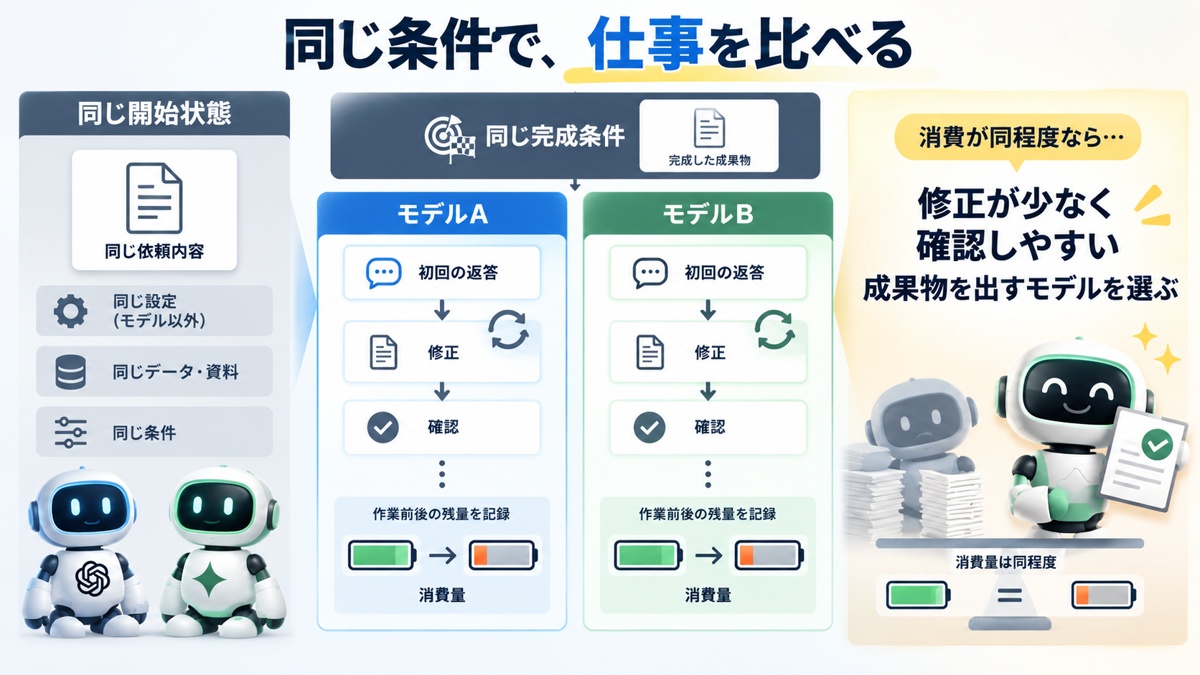
料金表は参考になりますが、自分のCodexでどの程度長く使えるかを知るには、実際の残量を比べるのが直接的です。大がかりな検証でなくても、普段よく頼む仕事をいくつか選べば、モデル選びの材料になります。
同じ開始状態と、同じ完成条件を用意する
ChatGPTアカウントで利用するCodexの中で、次のように条件をそろえて比較します。APIキーでの実行料金を、月額プランの残量と混ぜないようにします。
- 同じ資料・同じ未修正のファイルを用意する。 片方のモデルが直した成果物をもう片方へ渡さず、独立したスレッドで同じ開始状態から実行する。
- モデル以外の条件をそろえる。 x-high同士、Standard同士にし、指示、利用できるツール、追加エージェントの利用条件も合わせる。
- 作業前後の残量を記録する。 測定中は、同じ利用枠を使う別のCodexやWorkの作業を動かさず、リセットを挟まない期間で比べる。
- 完成まで追う。 初回の返答だけで終えず、必要な修正や確認まで含め、残量の減少・修正回数・成果物の品質を記録する。
使用状況は設定画面で確認でき、Codex CLIでは/statusから残りの利用枠を確認できます。また、CodexとWorkなどは利用枠を共有するため、並行作業を混ぜないことが重要です。[11][13]
小さな差より、普段の作業での傾向を見る
評価の基準は、「同じ完成条件を満たすまでに、残量を何ポイント使ったか」です。待ち時間の長さだけでは、どれだけ仕事が進んだかが分かりません。
表示が整数%なら、ごく短い作業の差は見えにくくなります。「表示が変わらなかったから消費ゼロ」とはせず、数種類の作業で繰り返し比べるほうが判断しやすいでしょう。実行順を入れ替え、初回実行か、同じ資料を繰り返し使った実行かも記録しておくと、結果を解釈しやすくなります。
消費が同程度なら、修正が少なく、確認しやすい成果物を出すモデルを選ぶ。新モデルのほうが少ない消費で仕上がるなら、節約のために旧モデルへ戻す必要はない。こうして自分の用途で判断すれば、体感をそのまま断定することも、料金表だけで結論を出すことも避けられます。
10月30日からはどうなる? 今だけの好条件と、モデルの効率改善
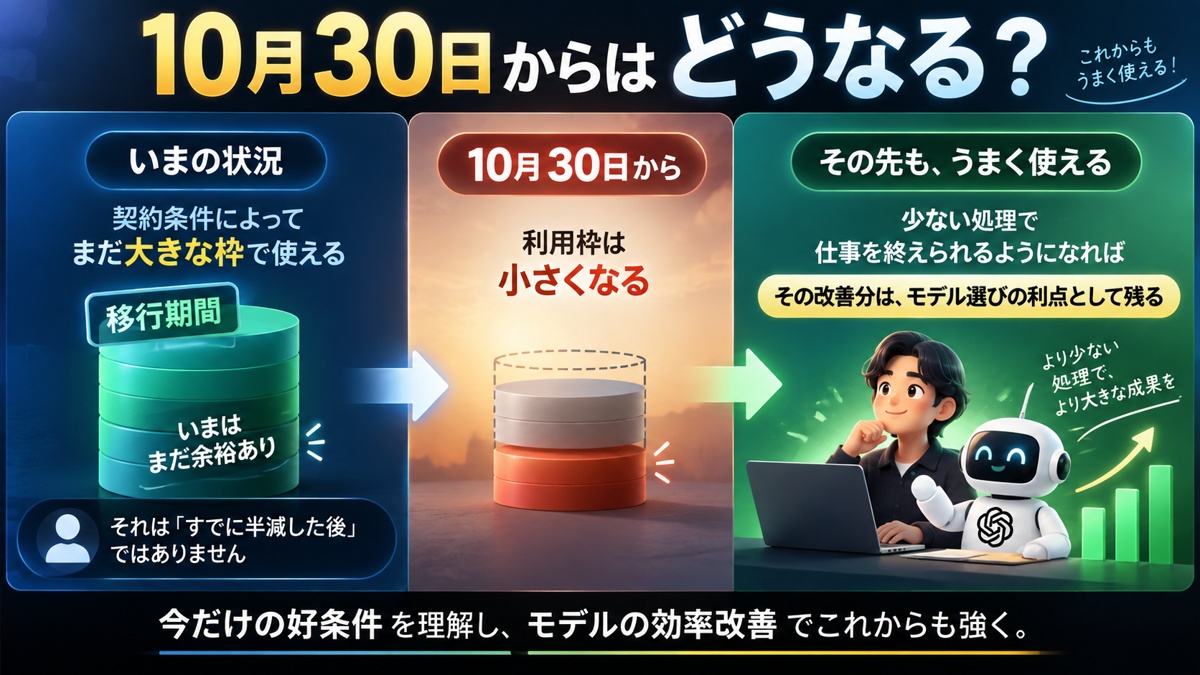
ここまでのモデル比較とは別に、Pro 200の利用枠そのものにも変更があります。いま残量に余裕を感じていても、その大きな枠がそのまま続くとは限りません。
対象となる既存Pro 200は、10月29日まで旧枠を維持
筆者に届いたOpenAIの変更通知では、2026年10月30日から、Pro 200に含まれるWork・Codexの利用枠を、Plusの20倍から10倍へ縮小すると案内されています。料金は変わらず、10月29日までは現在の利用上限を維持するという内容です。[16]
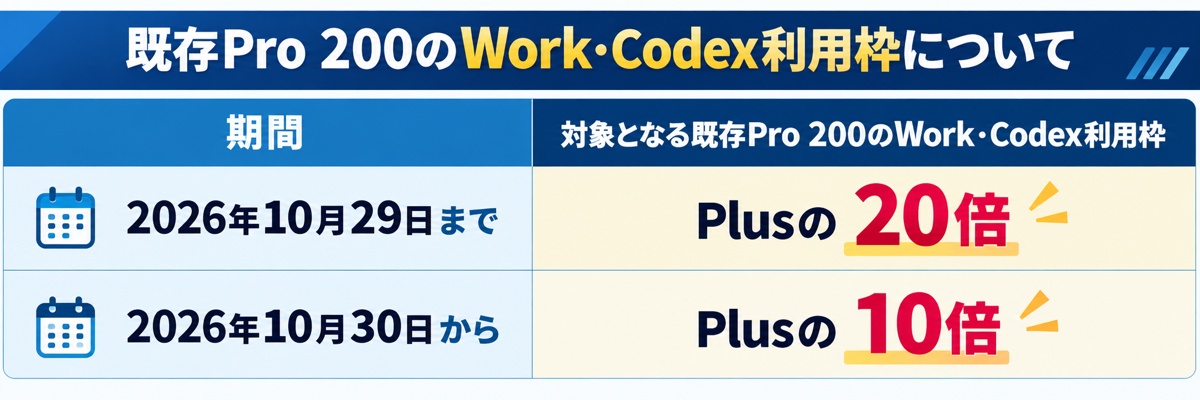
Pro 200の変更内容を詳しく確認したい方は、月額200ドルプランの変更を整理した記事も参考にしてください。
公式ヘルプでも、条件を満たす既存契約者は、Pro 200の契約が有効な間、10月29日まで以前の利用枠を使えると説明しています。旧枠維持の対象でない新規契約者には低い利用枠が適用されるため、同じPro 200でも、現時点では契約条件によって余裕が違います。[15]
対象者については、いまの状態を「すでに半減した後でも、こんなに使える」と捉えるのは違います。新しいSolを、まだ大きな旧枠で利用できている移行期間です。
利用枠だけが半分なら、同じ作業の消費率は2倍
モデル・設定・作業内容・消費の計算条件が変わらず、利用枠だけが半分になれば、同じ作業で減る残量%は計算上2倍になります。
いま残量を10%分使う作業は、枠が半分になった後なら20%分使う計算です。
これは「今の6.1 Sol」と「変更後の6.1 Sol」を比べた条件付きの試算です。「モデルの処理単価が2倍になる」「以前の5.6時代より2倍厳しくなる」という意味ではありません。実際の変更後の減り方は、適用後の使用状況で確認する必要があります。
なお、今回の通知には、5時間ごとの利用制限を再導入しないことも記載されています。利用枠の縮小と、短時間の制限の復活は別の話です。[16]
今だけなのは大きな旧枠。効率改善まで消えるわけではない
「今だけのボーナスタイム」と表現するなら、新しいモデルを、大きな旧枠で使える点については、その通りです。ただし、GPT-6/6.1 Solの料金や効率改善まで、10月30日に元へ戻すという案内ではありません。今回確認したモデルの発表では、新料金にそのような終了日は示されていません。[1][2][16]
また、移行支援として通知された62,500クレジットは、一度限りの付与で、有効期限は2026年12月31日です。通常の利用枠とは分けて考える必要があり、これも恒久的に増える枠ではありません。[16]
さらに、不定期の一斉リセットが重なると、いっそうお得に感じる人もいるでしょう。これはモデルの消費効率とは別に、作業を進められる機会を増やす上乗せとして捉えると分かりやすくなります。[9]
今後の見通しとしては、10月30日から利用枠は小さくなる。ただし、少ない処理で仕事を終えられるようになれば、その改善分はモデル選びの利点として残る。この2つを分けておくことが重要です。
まとめ|節約のために、性能を落とす必要があるとは限らない
Codexの残量が以前より減りにくいと感じたことをきっかけに調べてみると、Solは新世代で処理単価が下がり、性能と作業効率も改善する方向に進んでいました。少なくとも、「古いモデルにすれば、それだけで節約になる」とは言えません。[1][2]
一方、5.6 Solと6.1 Solのx-high同士で、残量の減り方が何倍違うかは、同じ仕事を実際に比べて判断する部分です。見るべきなのは、モデルの世代だけでなく、必要な品質の仕事を、どれだけ少ない消費と手戻りで完成させられるかです。
私なら、まず6.1 Solを基本にして、思考の強さや速度、任せる範囲を作業に合わせます。残量を節約するために、最初から旧モデルへ戻すとは限りません。節約したいからこそ、新しいモデルを避けずに試してみる。いまのCodexでは、その順番を考える価値があります。
#Codex #ChatGPT #AI活用
参考資料・出典
料金・仕様は2026年10月5日に確認した公開情報を基にしています。公式ページは随時更新されます。本文の体感は筆者の所感、比較手順は本記事の提案、利用枠半減後の消費率は条件付きの試算です。
[1] OpenAI「Introducing GPT-6 Sol and Luna」(2026年9月22日)。GPT-6 Solの発表、料金引き下げ、キャッシュ効率の改善。公式ページ
[2] OpenAI「Introducing GPT-6.1 Sol」(2026年9月29日)。GPT-6.1 Solの性能評価、OSWorld 2.0の比較、キャッシュ済み入力料金、提供開始。公式ページ
[3] OpenAI「Research」。GPT-6 Sol/Lunaの2026年9月22日、GPT-6.1 Solの9月29日の発表日を確認。公式ページ
[4] OpenAI「Better prompt caching for GPT-6」(2026年9月22日)。共通の入力を再利用する仕組みと、GPT-6でのキャッシュヒット率の改善。公式ページ
[5] OpenAI API「GPT-5.6 Sol Model」。標準料金、プロモーション期間、長い入力の料金条件。公式ページ
[6] OpenAI API「GPT-6 Sol Model」。標準料金、キャッシュ済み入力料金、料金条件。公式ページ
[7] OpenAI API「GPT-6.1 Sol Model」。標準料金、推論設定、長い入力・キャッシュ書き込みなどの条件。公式ページ
[8] OpenAI Developer Community、公式告知「20% price reduction for GPT 5.6 Sol: API, Codex credits and ChatGPT Work」(2026年8月21日、冒頭の告知本文)。API・クレジットの値下げと、Pro・Plus・Businessのサブスクリプション利用枠を変更しない旨。利用者の返信を公式仕様の根拠にはしていません。公式ページ
[9] OpenAI Help Center「Managing usage with GPT-6 Astra in Work and Codex」。GPT-6.1 Sol/6 Solの利用回数の目安、推論設定と消費の関係、Proの5時間制限、一斉リセットの扱い。公式ページ
[10] OpenAI API「Reasoning models」。思考用トークンの扱いと、APIで出力トークンとして課金される仕組み。公式ページ
[11] OpenAI「Pricing」(Codex/ChatGPT Learn)。使用状況の確認、CLIの/status、作業範囲や文脈を調整する考え方。公式ページ
[12] OpenAI「Speed」(Codex/ChatGPT Learn)。モデル、推論設定、速度設定を分けて考えるためのガイド。プランに含まれる利用枠のFast消費倍率は、別途Pro向け公式ヘルプの説明に基づきます。公式ページ
[13] OpenAI Help Center「Using Codex with your ChatGPT plan」。Codex・Workなどが利用枠を共有すること、使用状況の確認方法。公式ページ
[14] OpenAI API「GPT-6 Luna Model」。特定の作業を大量に扱う、効率重視のモデルとしての位置づけ。公式ページ
[15] OpenAI Help Center「About ChatGPT Pro tiers」。旧枠維持の対象は、2026年9月22日から9月29日午前10時(太平洋時間)までのいずれかの時点でPro 200の有効な契約があった利用者。契約が有効な間、旧枠を10月29日まで利用できると説明。対象外の新規契約には低い利用枠を適用。Fastの利用枠消費率が、同じモデルのStandardの2.5倍であることも確認。公式ページ
[16] OpenAI「ご利用の Pro プランに関する変更のお知らせ」(筆者受信、2026年9月30日・日本時間)。2026年10月30日からWork・Codexの利用枠をPlusの20倍から10倍へ縮小、10月29日まで旧上限を維持、料金据え置き、5時間制限を再導入しないこと、62,500クレジットの一度限りの付与と2026年12月31日の有効期限を確認。非公開メールのため、個人情報・受信箱へのリンクは掲載していません。
コメント