「GPT-6 Lunaが24位に登場」。そんなArenaの投稿で、むしろ目を引いたのはランキングのいちばん上でした。Claude Opus 5.5が1位、GPT-6 Astraが2位。先日、Sol・Lunaの新モデルを紹介したばかりですが、比較の見え方が変わる結果が出ています。[注][注][注]
2026年9月25日に確認したCode Arena:WebDevでは、Claude Opus 5.5(Max)が表示上の首位です。 さらに、別の総合的な能力評価でもトップに立っています。ただし、これを「すべての作業でOpus 5.5が最強」「Lunaは24位だから使えない」と読むのは早計です。[注][注]
今回は、Arenaの画像を入り口に、最新の公開結果と過去記事を照合します。新たに加わった評価、評価条件の違い、以前の説明を補足すべき点を整理し、日々のAI活用でどう受け止めるかまで考えます。
情報の確認日:2026年9月25日(日本時間)。 本稿は評価運営元と開発元の公開資料を照合した記事であり、筆者が各モデルのベンチマークを再実行した結果ではありません。順位や料金は確認時点の表示です。
関連記事: CodexにGPT-6 Sol/Luna登場|旧モデルとの性能・料金・トークン消費を徹底比較。Banked Resetも再配布
ArenaのWebDevでは、Opus 5.5が首位
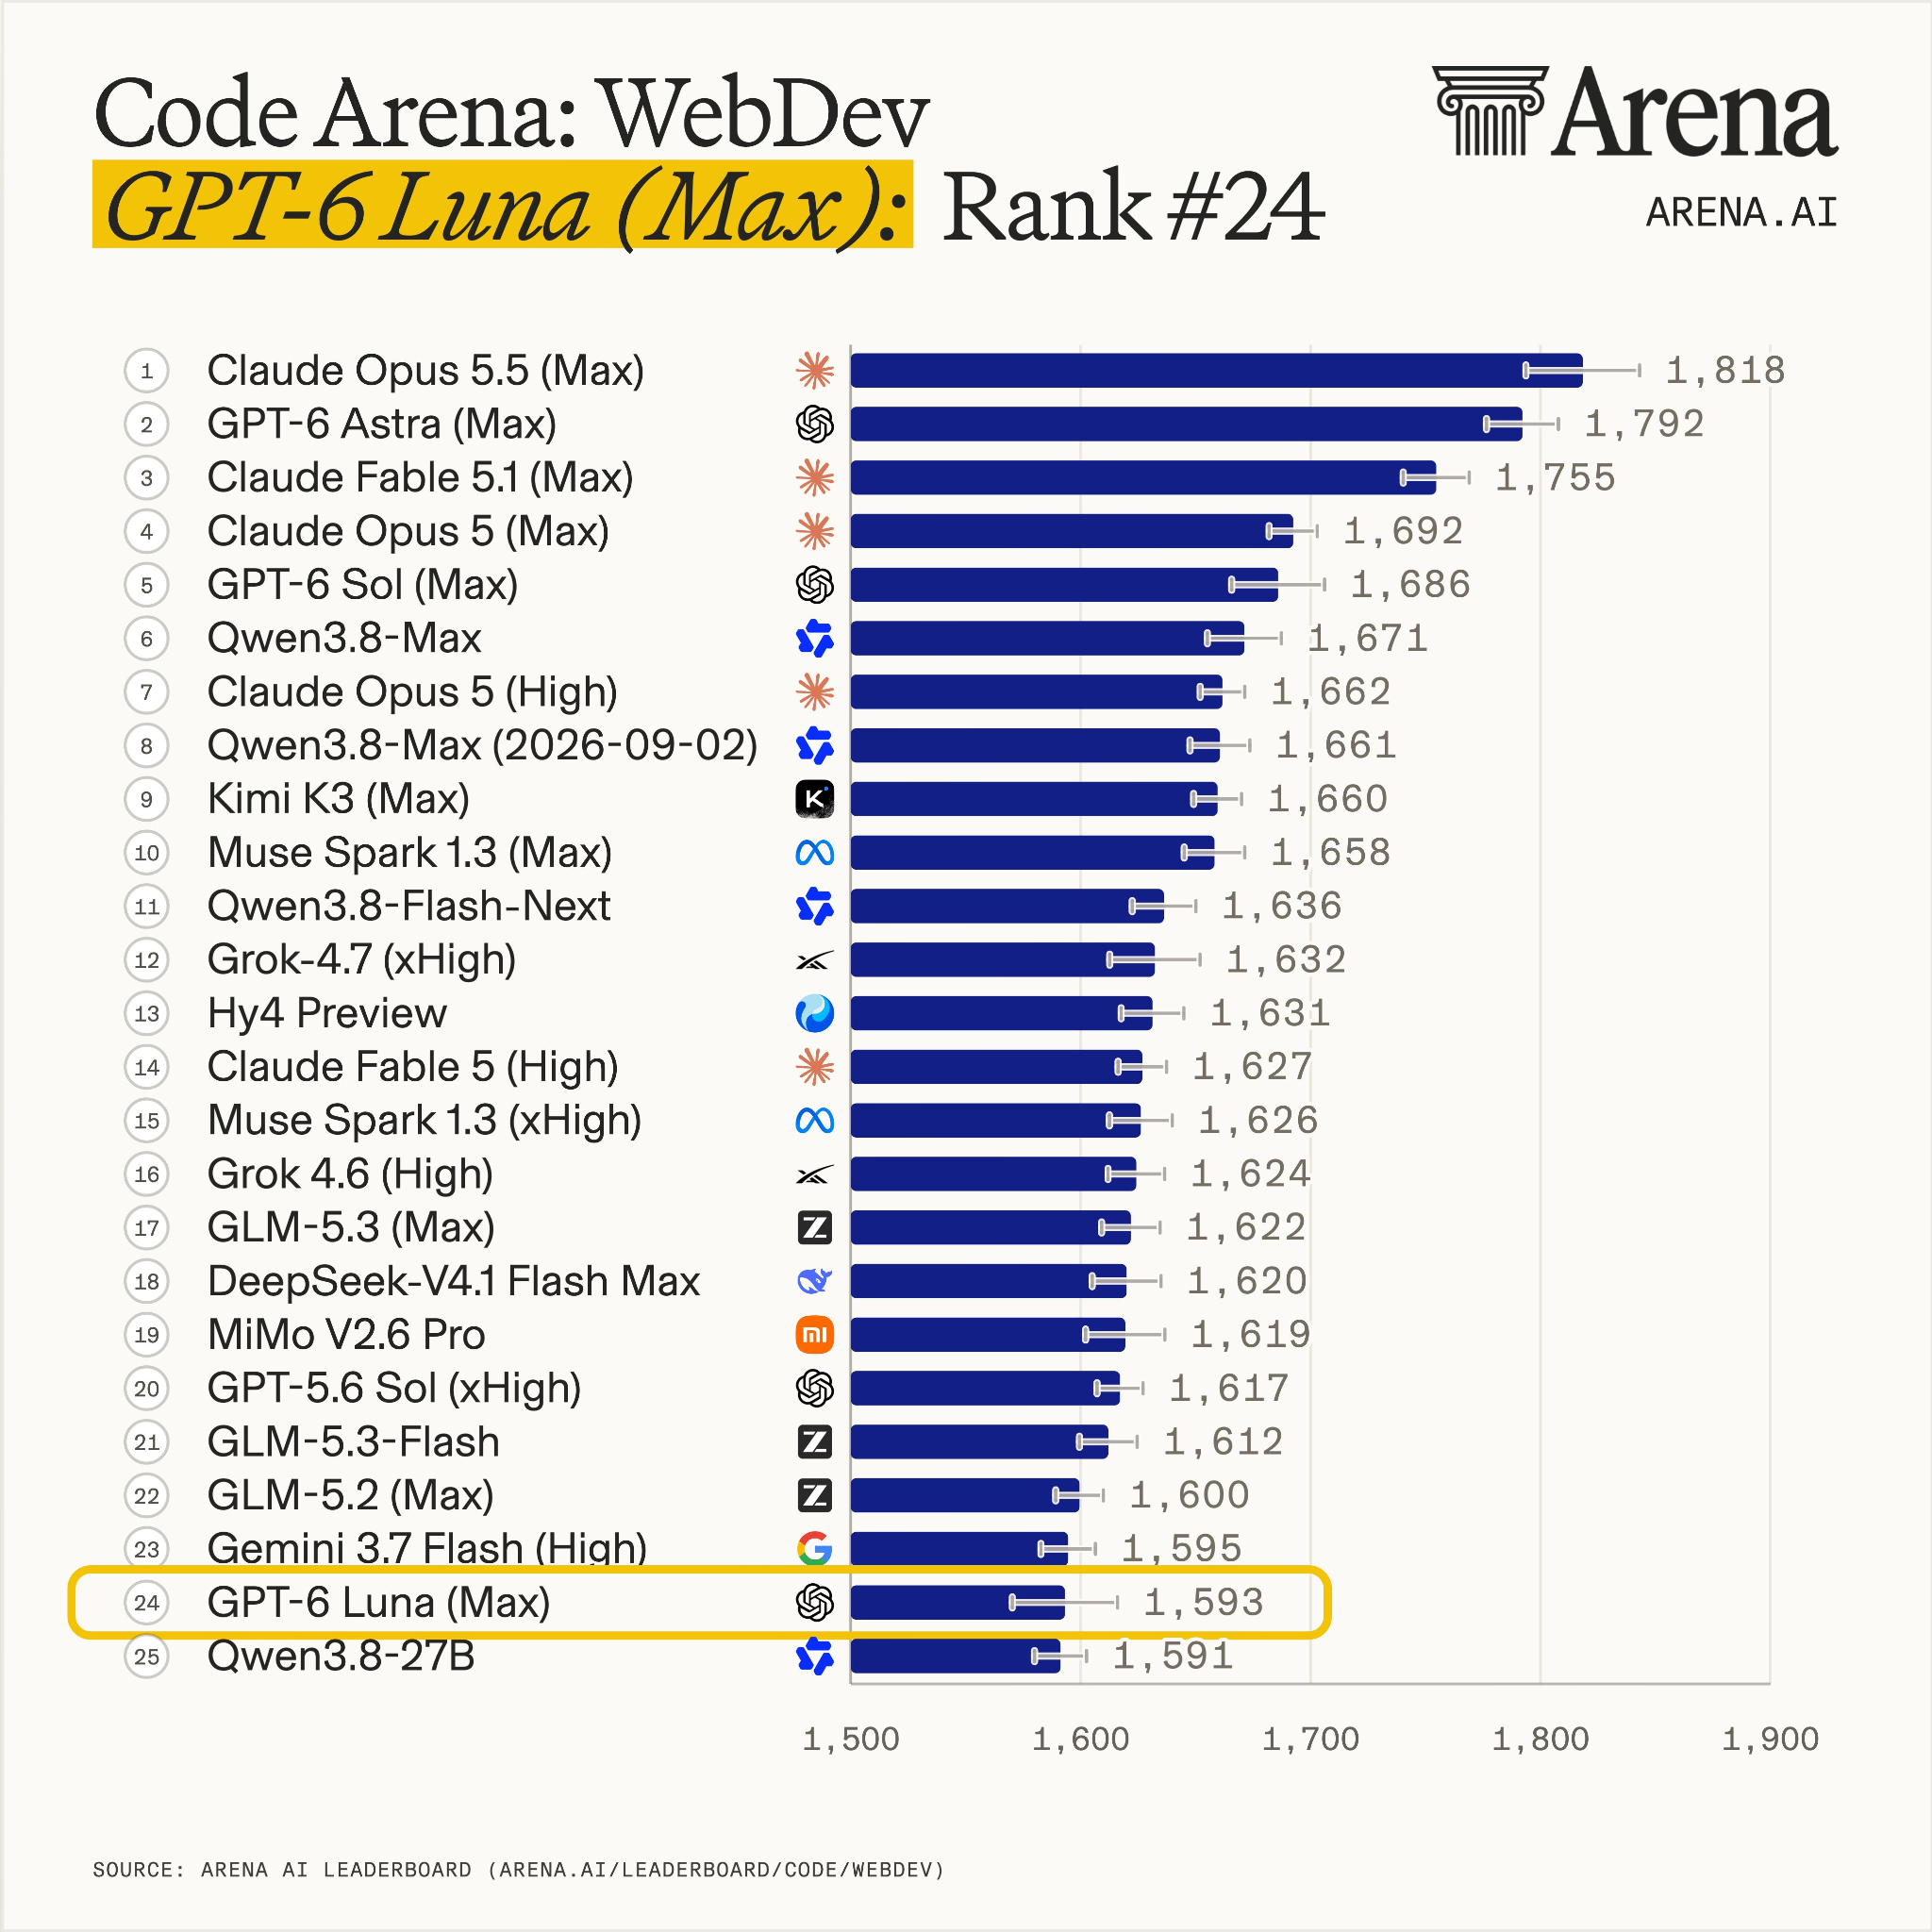
まずは、今回のきっかけになった画像です。
画像の順位は、公式リーダーボードと一致
まずは、今回のきっかけになった画像です。
図1:Arena公式X投稿のランキング図を引用。出典:Arena公式投稿。画像内の主要な順位・スコアは、9月25日に確認した公式リーダーボードと一致しています。原図のロゴ・出典表記を含め、改変せず掲載しています。[注][注]
主なモデルを抜き出すと、次のようになります。対象はWebDev部門の「Overall」であり、Arena全分野をまとめた順位ではありません。[注]
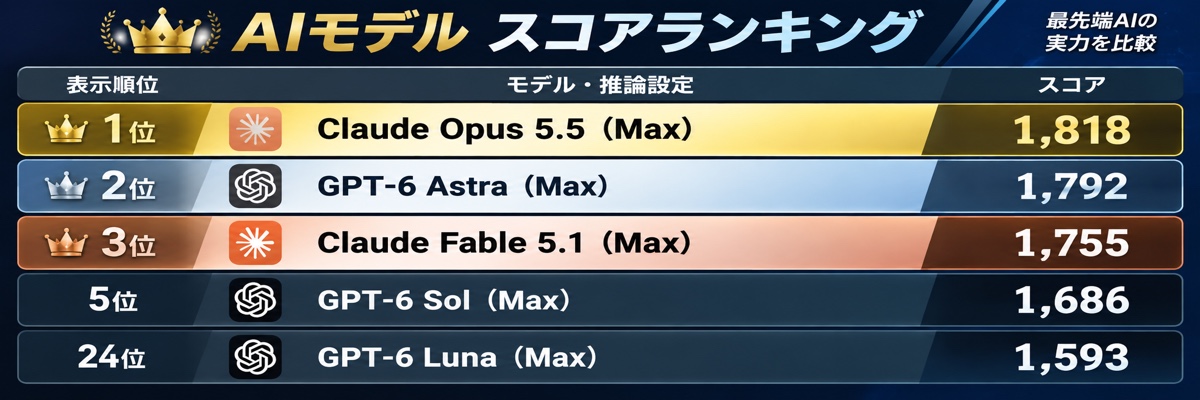
出典:Arena「Code Arena|WebDev・Overall」。9月25日確認。主な掲載モデルの抜粋。[注]
なお、MaxやxHighはモデルの推論設定です。Claudeの月額Maxプランとは別の意味なので、料金プランの比較と混同しないようにしてください。[注][注]
「Web制作で好まれた結果」と「開発能力のすべて」は別
Arenaは、モデル名を伏せて出力を比較し、利用者が良いと感じた方に投票する仕組みです。点数は比較投票を統計的にまとめた相対評価であり、正答率や作業の成功率ではありません。[注]
また、WebDevを「見た目の美しさだけを競う試験」と片付けるのも適切ではありません。 Code Arenaは、画面の試作だけでなく、データベースやログイン機能などを備えたWebアプリの開発にも対応しています。一方、その順位から、大規模な既存システムの保守性や安全性まで一括して判断することはできません。[注]
ブログのデザインやWebツールの試作をAIに頼む人にとって、今回の結果はOpus 5.5を比較候補に加える理由になります。ただし、完成した画面が気に入ることと、裏側の処理が正しく保守しやすいことは、実作業でも分けて確認したいところです。
Astraとの順序には、不確かさも残る
公式ページの「Rank Spread」という順位の幅は、Opus 5.5もAstraも1〜2位です。したがって、「表示上はOpus 5.5が首位」とは言えますが、「Astraに圧勝し、順序まで確定した」という表現は強すぎます。[注]
Web制作だけではない。総合指数でも高い評価
WebDevの順位とは別に、複数分野をまとめた評価も確認すると、Opus 5.5の位置づけを立体的に捉えられます。
複数分野をまとめた指数では58
開発元とは独立した評価を行うArtificial Analysisでも、Opus 5.5は首位です。確認時点の「Intelligence Index」は、主な比較対象で次の値になっています。[注]
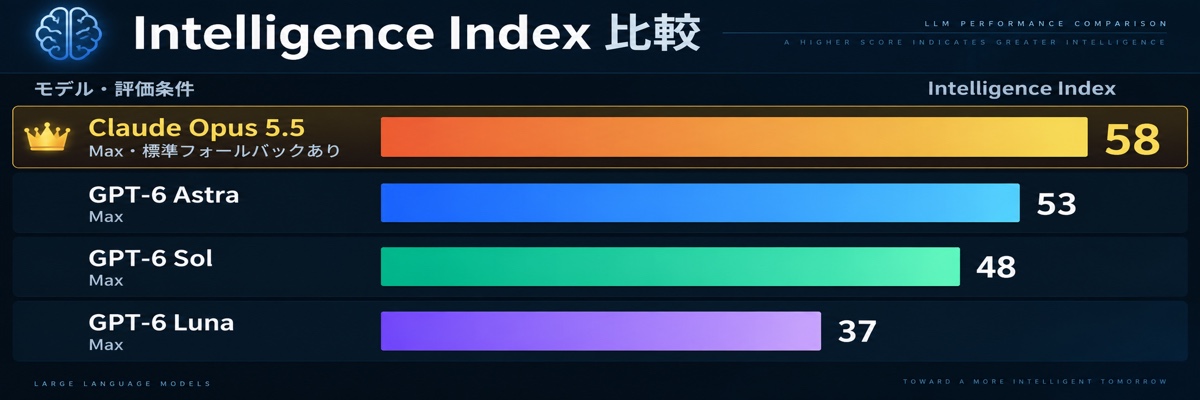
出典:Artificial Analysisの各モデルページ。9月25日確認。指数のバージョンはv4.3.2、数値はサイトに表示された整数値です。[注]
これは、開発、知識、文書を使った仕事など、10種類の評価をまとめた指数です。58は正答率58%ではなく、Astraとの差を「どんな仕事でも5%優れる」と読むこともできません。[注]
Opus 5.5の「標準フォールバックあり」は、所定の条件で補助モデルを使う設定を含むという意味です。この条件は、次章の業務自動化評価でも重要になります。[注][注]
前回のグラフは、GPT系モデル内の比較だった
9月23日の記事に掲載した総合指数のグラフは、Sol・Lunaの新旧モデルとAstraを比べたもので、Opus 5.5は含めていませんでした。そこでAstraがいちばん高く描かれていること自体は、競合を含めた首位を意味しません。[注]
今回の結果から補足できるのは、Opus 5.5の高評価は、Web制作の比較投票だけに限らないということです。ただし、評価元の報告でも、長い文書を使う推論など、首位ではない項目が残っています。総合指数の高さは有力な判断材料ですが、すべての得意・不得意が消えるわけではありません。[注]
過去記事と違うAutomationBench――40.0%と42.47%の関係
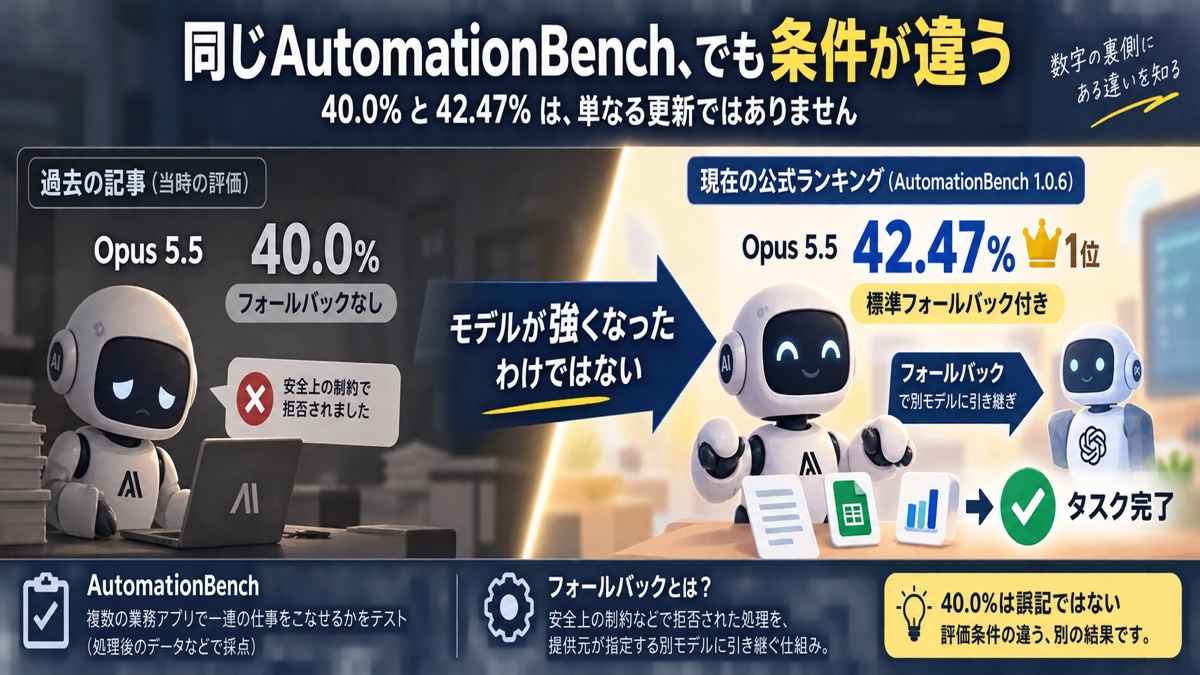
AutomationBenchは、フォールバックの有無で数値が変わるため、過去記事と同じ条件かを先に揃えて読みます。
同じ試験でも、掲載されている条件が変わっている
過去記事と直接見比べて、補足が必要なのが「AutomationBench」です。複数の業務アプリを模した環境で、一連の仕事を進められるかを測る試験で、文章の印象ではなく処理後のデータなどを採点します。[注]
前回の表では、Astraが41.4%、Opus 5.5が40.0%でした。ところが、9月25日に確認した公式ランキングでは、標準フォールバック付きのOpus 5.5が42.47%で先頭に掲載されています。[注][注]
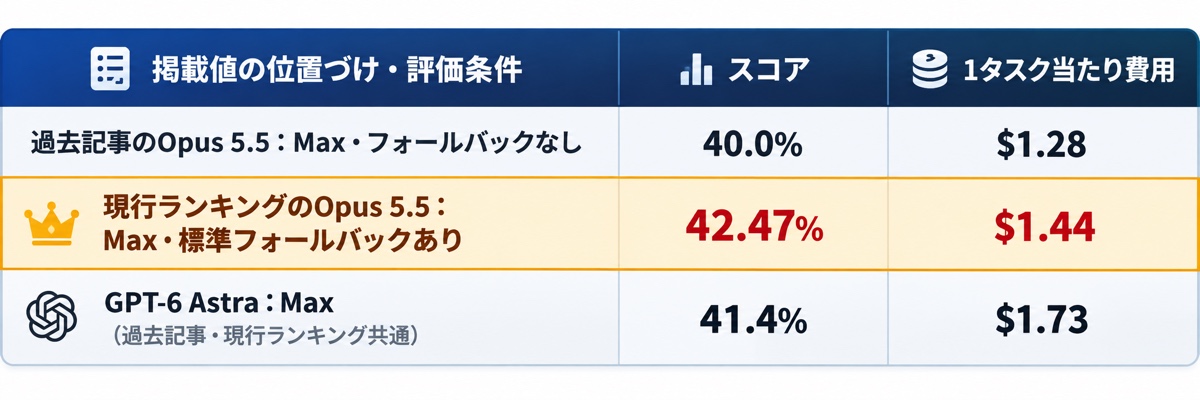
現行値はAutomationBench 1.0.6の公開表示。旧値・旧費用は過去記事の掲載図、旧評価がフォールバックなしである点はAnthropicの注記で確認しています。費用は試験の1タスク当たりの公表値であり、月額料金ではありません。[注][注][注]
フォールバックは「別モデルへ処理を引き継ぐ補助経路」
ここでいうフォールバックは、安全上の制約などで拒否された処理を、提供元が標準で指定する別モデルに引き継ぐ仕組みです。評価運営元は、拒否されたタスクをこの経路で再実行し、それ以外の結果は変えていないと説明しています。[注]
一方、Anthropicの発表ページには、今も40.0%が掲載されています。こちらはフォールバックを使わず、保護機能が介入した場合を失敗として数えた結果です。つまり、40.0%が誤記で、42.47%がその単純な訂正値という関係ではありません。[注]
同じOpus 5.5という名前でも、「単独で評価した結果」と「補助経路を含めた結果」は区別する必要があります。「モデルが数日でさらに学習して、40.0%から42.47%へ強くなった」と説明する根拠にもなりません。
前回の記事は当時の表を説明したものですが、現在のランキングを紹介する際には、数値だけでなく「標準フォールバックあり」まで含めて更新するのが適切です。なお、公開ランキングの切り替わった正確な日時は、今回確認した資料からは特定できません。
GPT-6 Lunaは24位。それでも評価が上がったと言える理由
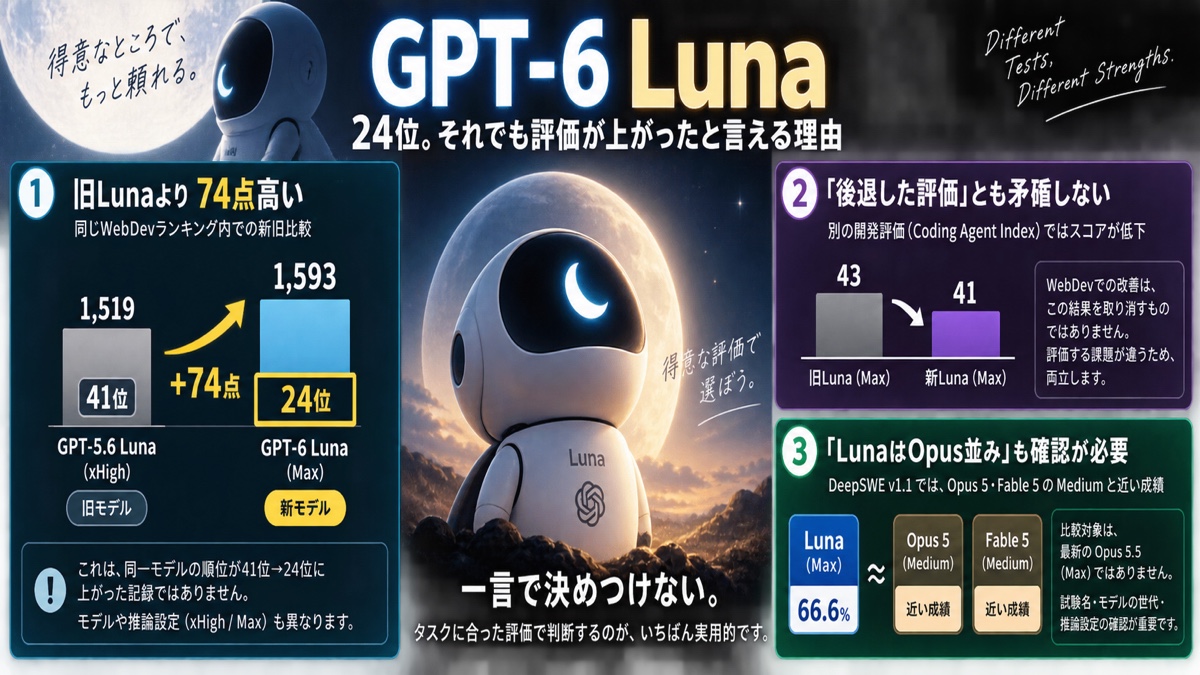
24位という順位だけで判断せず、同名の旧モデルとの差と、比較時の設定を分けて確認します。
同じランキングに載る旧Lunaより74点高い
今回の画像では、Lunaの24位が黄色く囲まれています。上位モデルとの差に目が向きますが、新旧比較では別の側面もあります。
同じWebDevランキングに掲載された旧GPT-5.6 Luna(xHigh・codex-harness)は1,519点で41位。新GPT-6 Luna(Max)は1,593点で24位となっており、掲載スコアは74点高くなっています。[注]
ただし、これは同一モデルの順位が過去の41位から24位へ動いた記録ではなく、同じ時点に掲載された旧モデルと新モデルの比較です。推論設定もxHighとMaxで異なり、モデル単体の更新効果だけを取り出した比較ではありません。
前回紹介した「後退した評価」とは矛盾しない
前回の記事では、独立評価について次のように説明しました。
Solは開発関連で改善が見られる一方、Lunaは後退した項目もある。
出典:9月23日公開の関連記事「開発能力の新旧比較では、SolとLunaで方向が違う」から引用。[注]
この根拠となった評価では、同じMax設定で比較したLunaのCoding Agent Indexが、旧モデルの43から新モデルの41へ下がっています。既存コードの理解などを含む、別の開発評価です。[注]
WebDevで良い結果が出たことは、この結果を取り消すものではありません。利用者がWeb制作の成果を比べる評価では改善し、別の開発課題をまとめた指数では後退することは、両立します。
今のLunaは「全面的に進化した」「全面的に劣化した」と一言でまとめるより、頼みたい作業に近い評価を見て判断する方が実用的です。
「LunaはOpus並み」も、相手と設定の確認が必要
OpenAIが公表したDeepSWE v1.1では、Luna・Maxは66.6%で、Opus 5やFable 5のMedium設定に近い成績とされています。比較対象は、最新のOpus 5.5・Maxではありません。[注]
このように、試験名、モデルの世代、推論設定を省いてしまうと、「LunaはOpusと同じくらい強いはずなのに、なぜ24位?」という混乱が生まれます。どちらかの結果が間違っているのではなく、比較している組み合わせが違うのです。
どこまでが新情報? 発表とランキング追加を時系列で整理
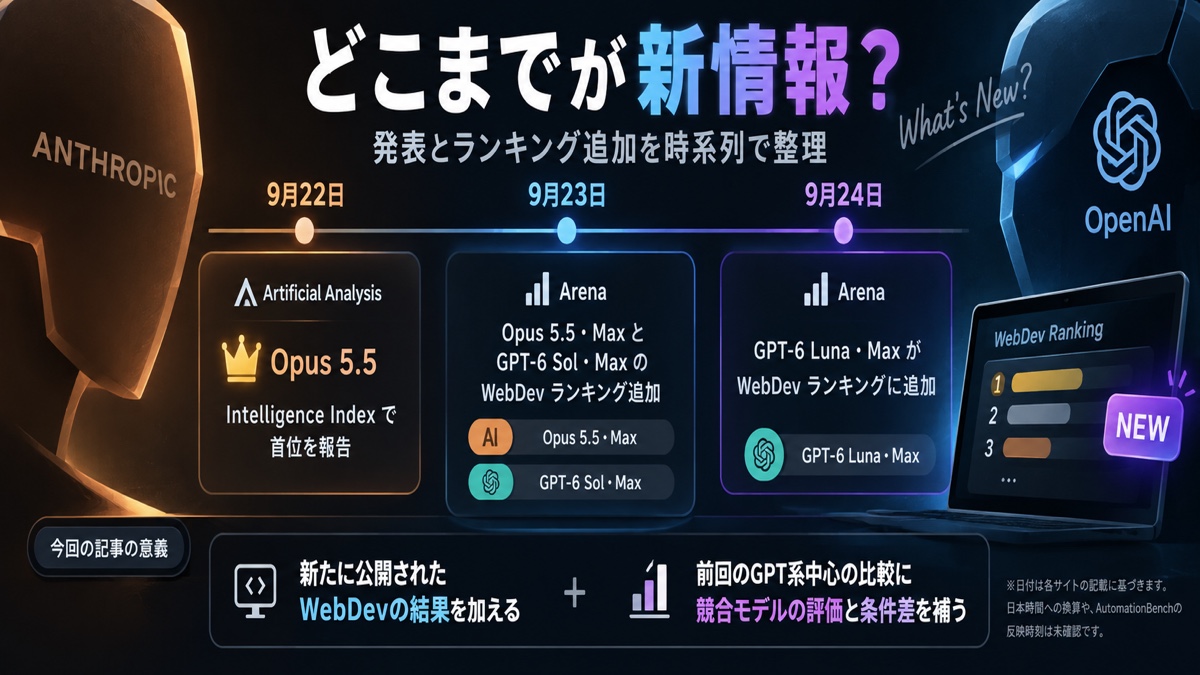
発表日とランキングへの追加日を分けると、今回どの情報が新たに確認できたのかが見えやすくなります。
今回確認した内容には、過去記事の後に加わった評価と、すでに公開されていた競合の評価が混ざっています。
- 9月22日: Artificial Analysisが、Opus 5.5のIntelligence Index首位を報告。これは9月23日の前回記事より前に公開されていた情報です。[注]
- 9月23日: Arenaの更新履歴に、Opus 5.5・MaxとGPT-6 Sol・MaxのWebDevランキング追加が記録されています。[注]
- 9月24日: GPT-6 Luna・MaxがWebDevランキングに追加されました。[注]
日付は各サイトの記載に基づきます。日本時間に換算した正確な公開時刻を表すものではありません。AutomationBenchの条件付き再評価が公開ランキングに反映された日時は未確認です。
したがって、今回の記事は「新たに公開されたWebDevの結果を加えること」と、「前回のGPT系中心の比較に、競合モデルの評価と条件差を補うこと」の両方に意味があります。過去記事の結論をすべて撤回する話でも、すべてを発表後の新発見として扱う話でもありません。
結局、Opus・Astra・Sol・Lunaをどう選ぶ?
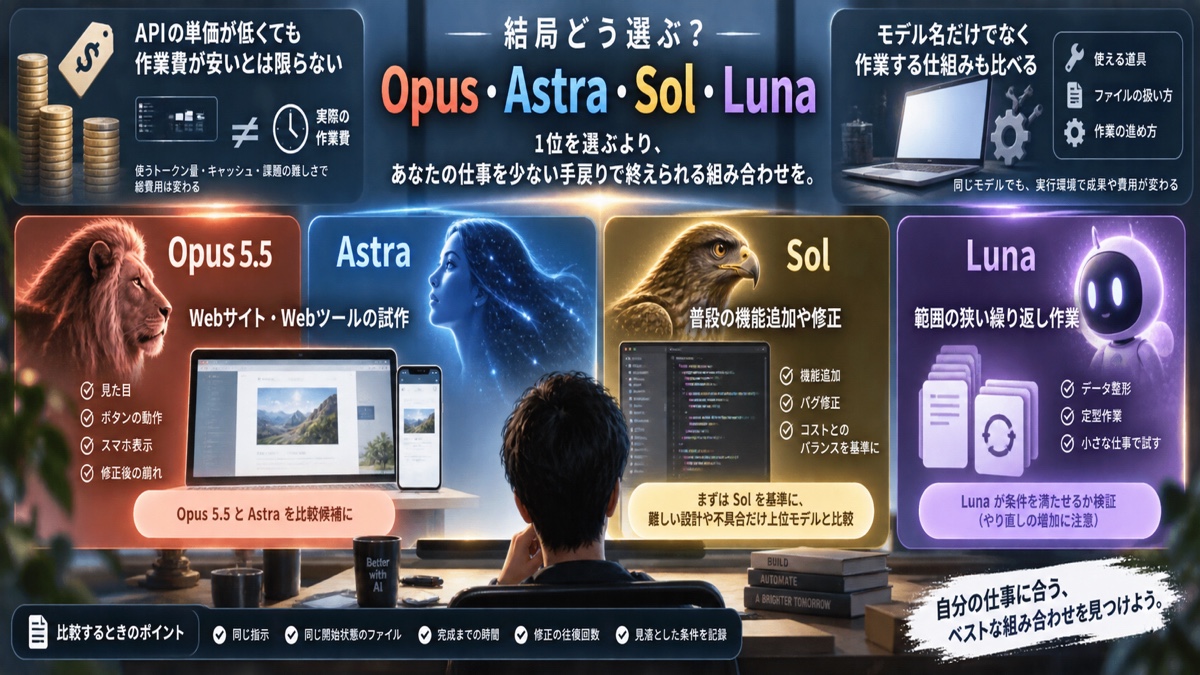
順位、成功率、API単価を一つの尺度に混ぜず、自分の作業に合うモデルを選ぶための見方を整理します。
API単価が低いモデルが、いつも作業費も安いとは限らない
通常のAPI料金を比べると、モデル間の価格差は大きくあります。以下はキャッシュを使わない通常入力と出力の基本単価で、100万トークン当たりの米ドル価格です。[注][注]
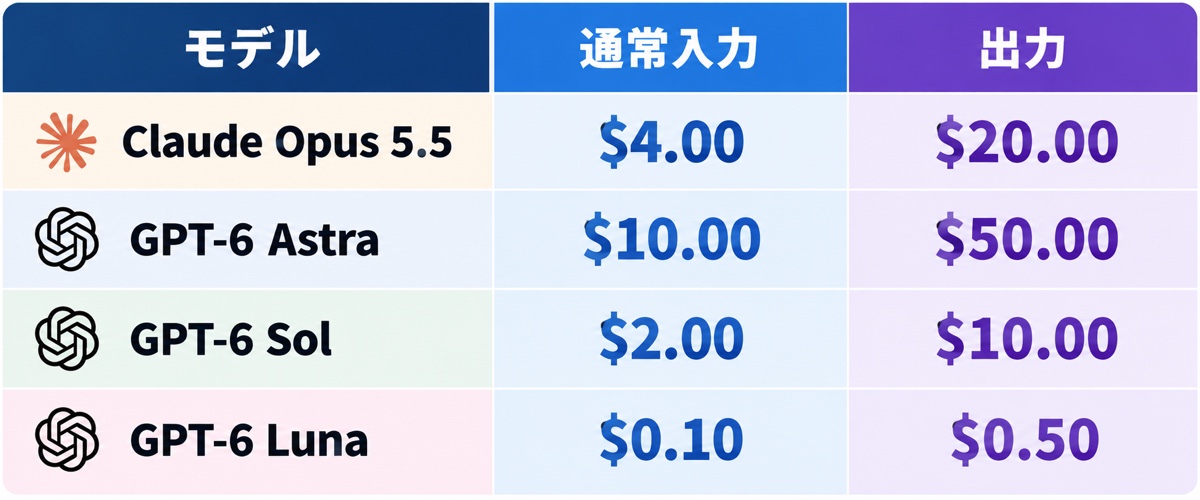
出典:各開発元の公式資料。長い入力、キャッシュ、速度設定などによる別料金は含めない基本単価の比較です。月額プランの利用枠を直接比較した表ではありません。[注][注]
この表だけならOpus 5.5はAstraより安いのですが、Intelligence Indexを測定した際の1タスク当たり費用は、Opus 5.5が$5.98、Astraが$3.26でした。反対に、先ほどのAutomationBenchの現行表示ではOpus 5.5の方が低い費用です。[注][注]
単価だけでなく、使ったトークン量やキャッシュなどが費用を左右するためです。Artificial Analysisの費用も、それぞれの試験の入力・推論・回答などを集計した加重平均であって、「どんな依頼でも1回この金額」という料金ではありません。[注]
モデル名だけでなく、作業する仕組みも比べる
もう一つ、CodexやClaude Codeで使う人が忘れたくないのが、モデルを動かす側の仕組みです。利用できる道具、ファイルの扱い方、作業の進め方まで変われば、モデルの順位だけでは実際の使い勝手を決められません。
Arenaが9月に公開した研究でも、モデルと実行環境を組み合わせた比較で、成功率が似ていても費用が大きく変わる例が報告されています。今回の新モデルを直接検証した研究ではありませんが、「モデル選び」と「作業環境選び」を分けて考える根拠になります。[注]
まずは、自分の仕事を3種類に分けて比較する
ここからは、公開結果を踏まえた本稿の使い分け案です。実機検証で優劣を確定した推奨ではありません。
- WebサイトやWebツールの試作: Opus 5.5とAstraを比較候補に。見栄えだけでなく、ボタンの動作、スマートフォン表示、修正後の崩れも確認する。
- 普段の機能追加や修正: Solを費用とのバランスを見る基準にし、難しい設計や不具合だけ上位モデルと比べる。
- 範囲の狭い繰り返し作業: Lunaが必要な条件を満たせるか、小さな仕事で試す。安さのメリットが、やり直しの増加で消えていないかを見る。
比べるときは、同じ指示と同じ開始状態のファイルを用意し、完成までの時間、修正の往復回数、見落とした条件を記録すると判断しやすくなります。異なるアプリで試した場合は、モデル単体ではなく、そのアプリを含めた仕事のしやすさを比べた結果として扱いましょう。
「1位を選ぶ」より、「自分の仕事を少ない手戻りで終えられる組み合わせを選ぶ」。 今回のランキングは、その比較にOpus 5.5を加える、具体的なきっかけになります。
まとめ:Opus 5.5は有力。ただし、順位と用途は分けて考える
Opus 5.5は、WebDevの比較投票でも、複数分野をまとめた能力指数でも、有力な結果を出しています。一方、AutomationBenchでは補助モデルの有無を残して読む必要があり、Lunaも試験によって新旧の評価が分かれます。[注][注][注][注]
今回見えてきたのは、どれか一社のAIに統一すべきという結論ではありません。高い完成度を狙う上位モデルと、費用を抑えて回せるモデルを、仕事に合わせて比べる意味があるということです。
Sol・Lunaの料金やCodexの利用枠、Banked Resetの説明は、9月23日の関連記事で整理しています。本稿は、その比較を最新の評価と競合の情報で補う続編として読んでいただければと思います。
出典・参考資料
以下は2026年9月25日に確認した資料です。開発元の自己評価、評価運営元の測定、当ブログの過去記事を区別しています。各リーダーボードは更新されるため、将来の表示と本稿の記載が一致しない場合があります。
[注] AI実践ラボ「CodexにGPT-6 Sol/Luna登場|旧モデルとの性能・料金・トークン消費を徹底比較。Banked Resetも再配布」(2026年9月23日)。過去記事の記述・掲載図との比較。https://ai-try-lab.com/gpt-6-sol-luna-codex-guide/ 。AutomationBenchの旧スコア・旧費用を確認した掲載図:https://ai-try-lab.com/wp-content/uploads/2026/09/gpt-6-sol-luna-codex-guide-table-02-20260923-v1.jpg 。GPT系の指数比較図:https://ai-try-lab.com/wp-content/uploads/2026/09/gpt-6-sol-luna-codex-guide-table-03-20260923-v1.jpg
[注] Arena「Code Arena|WebDev・Overall」。順位、スコア、Rank Spread、新旧Lunaの掲載条件。https://arena.ai/leaderboard/code/webdev 。ここでの「9月25日」は本稿の確認日で、ランキング生成日や全モデルの評価実施日を意味しません。
[注] Arena公式X投稿。ランキング画像および投稿画面を参照。https://x.com/arena/status/2103210975612780824 。画像中の順位・スコアは、注2の公式リーダーボードと照合しています。
[注] Arena「How Arena Works」「FAQ」。匿名比較、投票、Bradley–Terryによる相対評価の説明。https://arena.ai/how-it-works / https://arena.ai/faq
[注] Arena「Build, Deploy, and Evaluate with Fullstack Code Arena」(2026年7月2日公開、7月8日更新)。Web開発の評価・機能の範囲。https://arena.ai/blog/fullstack-code-arena
[注] Artificial Analysisの各モデルページ。Intelligence Index v4.3.2の表示値、Opus 5.5の評価条件、1タスク当たり費用。Claude Opus 5.5:https://artificialanalysis.ai/models/claude-opus-5-5 / GPT-6 Astra:https://artificialanalysis.ai/models/gpt-6-astra / GPT-6 Sol:https://artificialanalysis.ai/models/gpt-6-sol / GPT-6 Luna:https://artificialanalysis.ai/models/gpt-6-luna
[注] Artificial Analysis「Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index」(2026年9月22日)。首位報告の公開日、標準フォールバックの使用、個別評価での得意・不得意。https://artificialanalysis.ai/articles/claude-opus-5-5
[注] Artificial Analysis「Intelligence Benchmarking」。指数の構成・バージョン、費用集計の考え方、AutomationBench-AAの実施方法。https://artificialanalysis.ai/methodology/intelligence-benchmarking 。本稿で比較した業務自動化の42.47%などは、Artificial Analysis版ではなく、注9のZapier版の値です。
[注] Zapier「AutomationBench AI benchmark leaderboard」Version 1.0.6。現行スコア・費用、フォールバックで拒否タスクを再実行したという注記。https://zapier.com/benchmarks 。Opus 5.5の費用は公式ページの掲載値として記載し、請求ログから独自に再計算したものではありません。
[注] Anthropic「Introducing Claude Opus 5.5」。AutomationBenchの40.0%、フォールバックなしで測定したという脚注2。https://www.anthropic.com/claude-opus-5-5
[注] Artificial Analysis「GPT-6 Sol and Luna push the cost efficiency frontier」(2026年9月22日)。Codexの実行環境、Max設定で比較したCoding Agent Indexなど。https://artificialanalysis.ai/articles/gpt-6-sol-and-luna-push-the-cost-efficiency-frontier
[注] OpenAI「Introducing GPT-6 Sol and Luna」。DeepSWE v1.1のモデル・設定別比較、Sol・Lunaの基本API価格。https://openai.com/index/introducing-gpt-6-sol-and-luna/ 。競合の結果には公開報告の引用が含まれるという開発元の注記も確認しています。
[注] Arena「Leaderboard Changelog」。9月23日のOpus 5.5・Sol、9月24日のLunaのWebDev追加。https://arena.ai/company/leaderboard-changelog
[注] Anthropic「Claude Opus 5.5 — Claude Platform Docs」とOpenAI「GPT-6 Astra Model」。各モデルの基本API価格。https://platform.claude.com/docs/en/models/opus-5-5/overview / https://developers.openai.com/api/docs/models/gpt-6-astra
[注] Arena「HarnessTax: How Much Does the Harness Matter for Coding Agents?」(2026年9月16日公開、9月18日更新)。7モデル・3実行環境の21組合せを、SWE-bench LiteとTerminal-Bench 2.0の各30課題、各3回で比較した研究。今回の新モデル自体の優劣を裏付ける資料ではなく、実行環境で費用が変わり得るという論点に限って参照。https://arena.ai/blog/coding-agents-harness-tax
コメント