2026年9月23日の日本時間未明(米国では9月22日)、OpenAIが「GPT-6 Sol」と「GPT-6 Luna」を発表しました。先に登場した上位モデル「GPT-6 Astra」に続き、Codexで使うモデルの選択肢が広がります。[注]
今回の注目点は、単に「新しいモデルになった」ことではありません。SolとLunaはAPI料金が大きく下がり、日常的な開発や繰り返し作業に使いやすくなりました。一方で、性能がすべての評価で上がったわけではなく、実測のトークン消費も一律には減っていません。[注][注][注]
また、リリースに合わせてBanked Resetの配布も告知され、筆者のアカウントにも9月23日の朝、再び届きました。この記事では、その内容も含めて「何が良くなったのか」「どのモデルを選ぶとよいのか」を整理します。
情報の基準日:2026年9月23日。 ベンチマークはOpenAIの公表値、評価運営元の公開結果、独立評価のArtificial Analysisを区別して掲載しています。筆者自身が各モデルのベンチマークを再実行した記事ではありません。料金は原則として米ドル建ての公表単価で、税・為替換算は含みません。
GPT-6 SolとLunaとは? Astraとの違いと提供範囲
まずはSol・Luna・Astraの役割と、発表時点でどこから利用できるのかを分けて確認します。
Codexは「作業する仕組み」、モデルは「考える頭脳」
最初に言葉を整理しましょう。Codexは、コードを書き、調べ、修正し、レビューするためのAIエージェントです。GPT-6 SolやLunaは、その作業で使うAIモデルに当たります。今回は、OpenAIが公開した新モデルを、Codexなどから使えるようになったというニュースです。[注][注]
同じCodexに同じ指示を出しても、選ぶモデルや考える深さによって、得意な作業、待ち時間、利用枠の消費が変わります。
3モデルの役割をざっくり整理
- GPT-6 Astra: 難しい問題にじっくり取り組む上位モデルです。複雑な設計、原因が見えない不具合、重要な変更の検討が候補になります。
- GPT-6 Sol: 開発能力と費用のバランスを取る中心モデルです。複数ファイルの修正、機能追加、通常の開発・調査から試しやすい位置づけです。
- GPT-6 Luna: 速度と低コストを重視するモデルです。範囲を絞った修正、抽出・分類、テストのたたき台、反復作業が候補になります。
位置づけは公式のモデル説明に基づき、作業例は本稿の使い分け案です。Lunaもコーディングに対応しており、「要約だけのAI」「プログラムを書けない廉価版」という理解は正確ではありません。[注][注][注][注]
また、今回GPT-6の3モデルがそろったことと、旧モデルがすべて消えたことは別です。GPT-5.6 Sol・Terra・Lunaなども公式資料に掲載されており、利用できる選択肢は契約とクライアントで確認する必要があります。[注]
普通のChatGPTのチャットと、Codexでの提供は別
発表時点では、Plus/Pro/Business/Enterprise/EduにChatGPT WorkとCodexでSol・Lunaが提供され、Free/GoではデスクトップアプリからLunaを利用できます。OpenAI APIのモデルIDはgpt-6-solとgpt-6-lunaです。一方、通常のChatGPTのChatには、発表時点ではまだ提供されていません。[注]
段階的な展開のため、新モデルが表示されるタイミングには差があります。「普通のチャット欄に出ないから未配信」「Codexのどの実行方式でも、すべて新モデルに置き換わった」とは限りません。クラウド実行については、後半で補足します。[注]
API料金はどれだけ安くなった? 旧モデルと比較
料金の変化は、APIの従量課金とChatGPTの月額プランを混同せずに見ることが重要です。
API料金と、ChatGPTの月額料金を分けて考える
APIは、アプリやプログラムからAIを呼び出す窓口です。APIキーで使った料金と、ChatGPTの契約に含まれるCodexの利用枠は、別の課金の仕組みです。
そのため、今回の「API価格を約半分に」という発表は、ChatGPT PlusやProの月額料金そのものが半額になった、という意味ではありません。[注]
100万トークン当たりの新旧価格
トークンは、AIが文章やコードなどを処理するときの単位です。文字数とは一致せず、日本語でも「1文字=1トークン」と固定して計算できるものではありません。まずは、入力を読む量と、出力する量に応じた従量料金だと捉えると分かりやすくなります。[注]
以下は、通常のStandard料金です。キャッシュ読み取りは、再利用できた入力部分の料金を指します。[注][注][注][注][注]
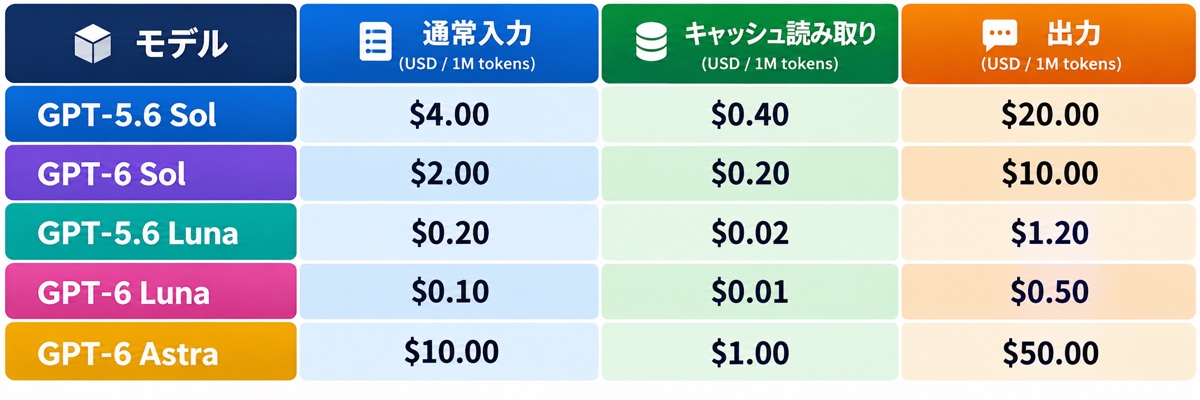
※すべて100万トークン当たり。OpenAIの「約50%安い」は、旧GPT-5.6のプロモーション価格との比較です。キャッシュ書き込み、長い入力、速度設定などの条件は別途確認が必要です。[注]
Solは、通常入力・キャッシュ読み取り・出力のいずれも旧モデルの半額です。Lunaは入力が半額ですが、出力は$1.20から$0.50へ、計算すると約58.3%の値下げになります。「すべての項目が厳密に50%減」と書くより、実際の単価を見る方が正確です。
同じ種類・同じ量のトークンを使うなら、新Lunaの単価は新Solの20分の1、Astraの100分の1です。ただし、これは処理能力が20分の1という意味でも、どんな仕事でも請求額が100分の1になるという意味でもありません。
同じ量を読み書きした場合の料金例
通常入力10万トークン、課金対象の出力1万トークンを使うと仮定して、単価だけを比較してみます。出力には、回答文だけでなく課金対象の推論トークンも含めます。[注]
この条件では、GPT-5.6 Solが1回$0.60、100回で$60.00、新Solが1回$0.30、100回で$30.00です。GPT-5.6 Lunaは1回$0.032、100回で$3.20、新Lunaは1回$0.015、100回で$1.50になります。Astraは1回$1.50、100回で$150.00です。
これは、各モデルの公表単価から計算した架空の同量比較です。実際のタスクの測定結果ではありません。キャッシュ読み取り・書き込み、追加のツール利用料、速度や地域による加算は含めず、通常入力だけとして計算しています。
計算式は「入力トークン数÷100万×入力単価+出力トークン数÷100万×出力単価」です。ここに、実際にはモデルごとの使用量や再試行の差が加わります。
一度に扱える量が、今回急に倍増したわけではない
新Sol・LunaのAPI仕様は、1回の処理で扱う長さの上限である「コンテキストウィンドウ」が1,050,000トークン、出力上限が128,000トークンです。旧Solも同じ上限でした。今回の中心は、単純な容量拡大というより、能力・価格・効率の更新です。[注][注][注]
大きな上限があることと、長い会話の全情報を常に正しく使えることは別です。また、APIの上限をそのままCodexの全画面に当てはめるのではなく、実際のクライアントの表示も確認してください。
長い入力とキャッシュ書き込みには別条件がある
新Sol・LunaのAPIでは、入力が272,000トークンを超えるリクエストは、入力・キャッシュ関連料金が2倍、出力料金が1.5倍になります。超えた部分だけを通常の単価表に足せばよい、という仕組みではありません。[注][注]
また、キャッシュ書き込みは通常入力の1.25倍で、新Solなら100万トークン当たり$2.50、新Lunaなら$0.125です。安い「読み取り料金」と、最初に再利用用の状態を作る「書き込み料金」を混同しないようにしましょう。[注]
性能比較① OpenAIの公表値と業務・開発ベンチマーク
ここではOpenAIの公表値と評価運営元の結果を、試験条件を残したまま読み解きます。
点数を見る前に、3つの条件を確認
ベンチマークは、AIに共通の問題を解かせて比べる試験です。ただし、同じモデルでも、使わせる道具や考える時間によって結果は変わります。
特に確認したいのは、何の試験か、推論設定は何か、誰がどの実行環境で測ったかです。たとえばmaxは、そのモデルに多くの推論を使わせる設定です。mediumのモデルと比べるときには、この違いを残して読む必要があります。[注]
なお、68.8%と69.9%の差は「1.1ポイント」です。「性能差が1.1%」と書くと意味が変わります。また、後述する総合指数の48や53は、正答率48%・53%ではありません。
DeepSWE:Solは高い開発性能、Lunaも安さだけではない
実際のコードベースを使った複雑な開発課題を測るDeepSWE v1.1では、OpenAIは次の結果を公表しています。[注]
GPT-6 Sol・maxは68.8%で、Claude Fable 5・xhighの69.9%より1.1ポイント低い一方、1タスク当たりの費用は約80%低いとされています。GPT-6 Luna・maxは66.6%で、Opus 5・mediumとFable 5・mediumに近い水準です。[注]
Lunaの同程度のスコアでの費用比較は、Opus 5より93%低く、Fable 5より96%低いというものです。[注]
ここで、「API単価」「この試験の1タスク当たり費用」「スコアが近い設定の組み合わせ」は別の数字です。SNSのグラフを見て、すべてを「Lunaなら常に他社の50分の1」とまとめるのは避けたいところです。
新旧モデルの具体的な数値を比べられる独立評価は、次章に掲載します。
業務自動化:安さと最高得点を両立するとは限らない
AutomationBenchは、複数の業務アプリやツールを使って、一連の仕事を完了できるかを測る試験です。運営元の公開ランキングには、同日発表のClaude Opus 5.5も掲載されています。バージョン1.0.6の主な結果は次のとおりです。[注]
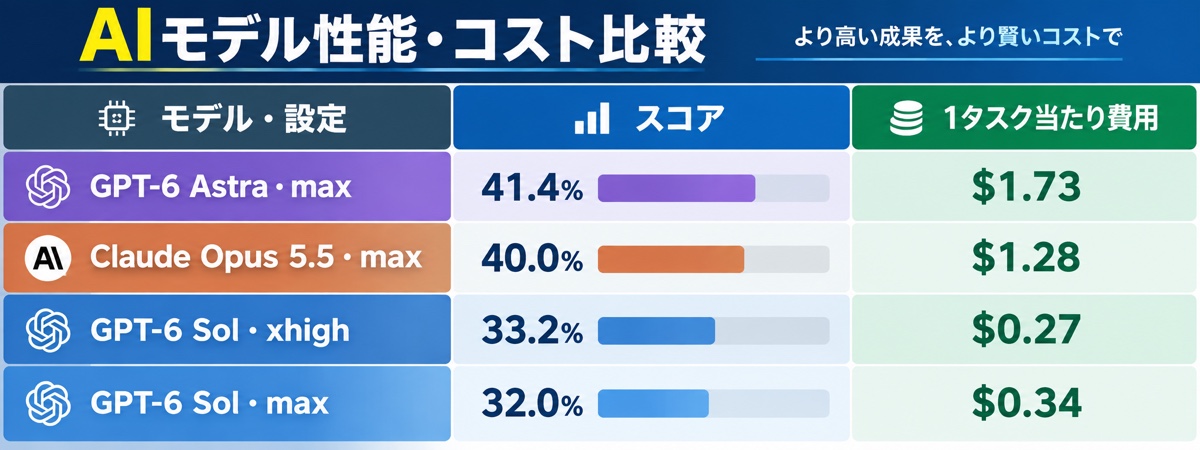
この表からは、Astraがより高い得点を取り、Solは低い費用で一定の能力を発揮していることが読み取れます。また、Solではmaxがxhighより必ず高得点になっているわけではありません。
ただし、この一点で「maxは不要」と一般化するのも早計です。試験にはばらつきがあり、タスクとの相性もあります。推論を増やした分だけ、得点が一直線に上がるわけではないと理解するのが適切でしょう。
この試験は、求められた条件をすべて満たすことを重視する厳しい判定です。33.2%という数字を、そのまま「自分がCodexに頼む仕事の3回に2回は失敗する」と読み替えることもできません。[注]
その他の公表値は、何を評価した数字なのか
その他の公表値も、試験の意味を分けて読む必要があります。
- FrontierCode 1.1 Main: 正しく動くだけでなく、テストや変更範囲も含め、そのまま取り込めるコードかを評価します。Solは旧Solを改善し、Fable 5.1・xhighに低コストで並ぶと説明されています。
- Agents’ Last Exam V1: 長い工程を伴う専門的なPC業務の評価です。Sol・maxは56.4%で、比較対象のOpus 5より1タスク当たりの費用を60%抑えたとされています。
- OSWorld 2.0 offline: PCを操作して進める一連の仕事を測ります。Sol・xhighは60.5%、Opus 5・mediumは60.3%で、Solの費用は約80%低いという結果です。
出典はOpenAIの発表です。OSWorldの数値は「部分的な達成も加点する報酬」の評価で、すべての作業を完了した割合と同義ではありません。[注]
こうした結果は、Solが単なる文章生成の廉価版ではなく、コード編集やPC業務を継続して進めるモデルとして作られていることを示します。ただし、OpenAI側と競合側で評価環境が完全に統一されているとは限らず、実際のCodexの挙動と一致する保証もありません。[注]
「Claudeより上」とまとめる前に、世代もそろえる
比較表には、Opus 5、Opus 5.5、Fable 5、Fable 5.1などが登場します。Anthropicも9月22日にOpus 5.5を発表しており、Opus 5に対する優位性を、そのまま最新Opus 5.5への優位性に置き換えることはできません。[注]
同じベンチマーク、同じバージョン、同程度の設定で比較できる項目を選ぶことが重要です。発表の前後関係だけで、全面的な勝ち負けを決める必要はありません。
性能比較② 独立評価では「改善」と「後退」が混在
開発元とは独立した評価では、新旧モデルの変化が指標によって異なることも見えてきます。
総合指数は、Solが小幅上昇、Lunaは同水準
開発元とは独立して評価を行うArtificial Analysisのモデル別ページでは、確認時点の総合指数は次のようになっています。[注][注][注][注][注]
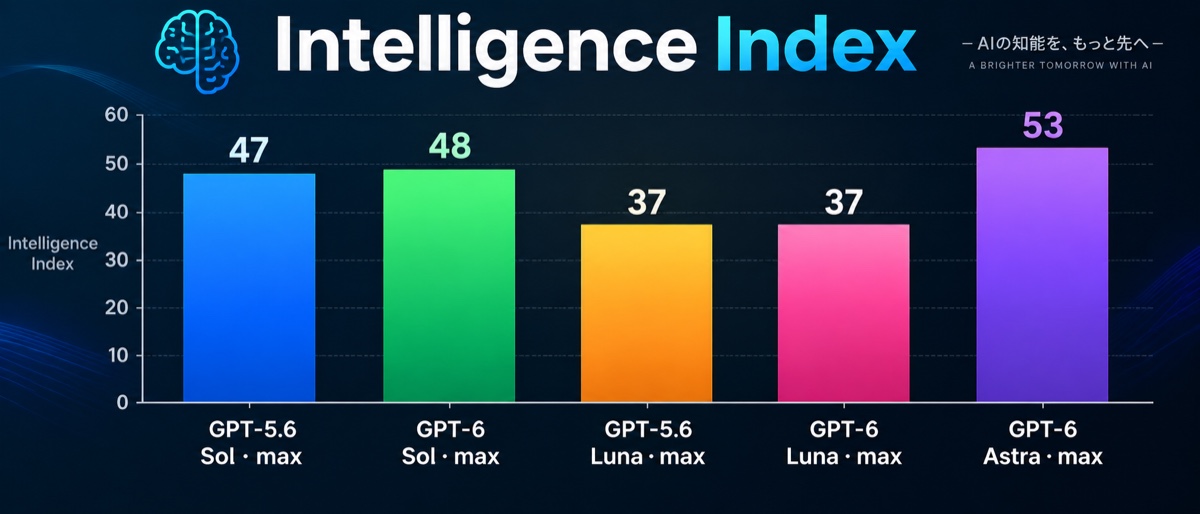
これは複数の試験をまとめた指数です。Solが48だから「作業の48%にしか成功しない」という意味ではなく、1ポイントの差から、あらゆる用途で体感できる差があるとも言えません。
少なくとも、この総合評価だけを見るなら、今回の更新を「知能が全面的に大幅上昇した」と表現するのは強すぎます。
開発能力の新旧比較では、SolとLunaで方向が違う
同機関がCodexの実行環境で比較した開発関連の結果は、次のとおりです。すべてmax設定です。[注]
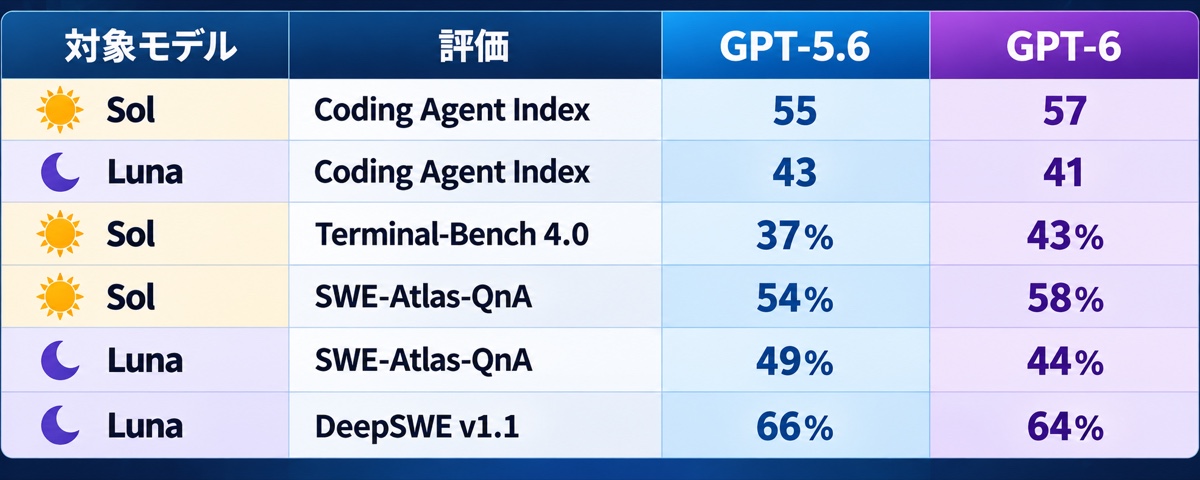
Coding Agent Indexは開発関連の試験をまとめた指数、残りは各試験のスコアです。新旧の比較値を確認できた項目を抜粋しています。
Solは開発関連で改善が見られる一方、Lunaは後退した項目もある。 価格が下がった価値は大きいものの、「Lunaに変えれば旧モデルより必ず賢くなる」という勧め方はできません。
なお、LunaのDeepSWEはOpenAIの評価では66.6%、独立評価では64%です。実行環境や評価手順が異なるため、同一条件の結果としてまとめず、別々に扱います。
「間違いが減った」と「正解が増えた」も別
OpenAIは、過去に利用者が誤りを指摘した会話を使う内部評価で、Solの事実誤りが旧モデルのおよそ半分になったと説明しています。ただし、これは誤りが出やすい会話を集めた評価で、普段の全回答の誤り率を表すものではありません。[注]
独立評価の知識問題では、新Solは回答を試みる割合が99%から83%へ下がり、全問題に対する正答率も59%から54%へ下がりました。無理に答えないことで、誤答が減る側面があります。[注]
たとえば、分からないことを「分からない」と言えるのは望ましい変化です。しかし、それだけで「知っていることが増えた」「調べなくても正確」とは言えません。ニュースや専門情報の確認では、新モデルでも出典を確かめる作業は残ります。
短くなった回答で、必要な内容まで抜けないか
独立評価は、一部の知識労働・成果物作成の試験で後退も報告しています。必要な項目の欠落や、成果物の見せ方の低下が見られたという指摘です。[注]
これは記事、提案書、仕様書などを作る人にも関係します。読みやすく簡潔になることと、必要事項を省いてしまうことは違います。短さだけで採用を決めず、「必須の内容が残っているか」を確認しましょう。
トークン使用量は減った? 実測コストとキャッシュの仕組み
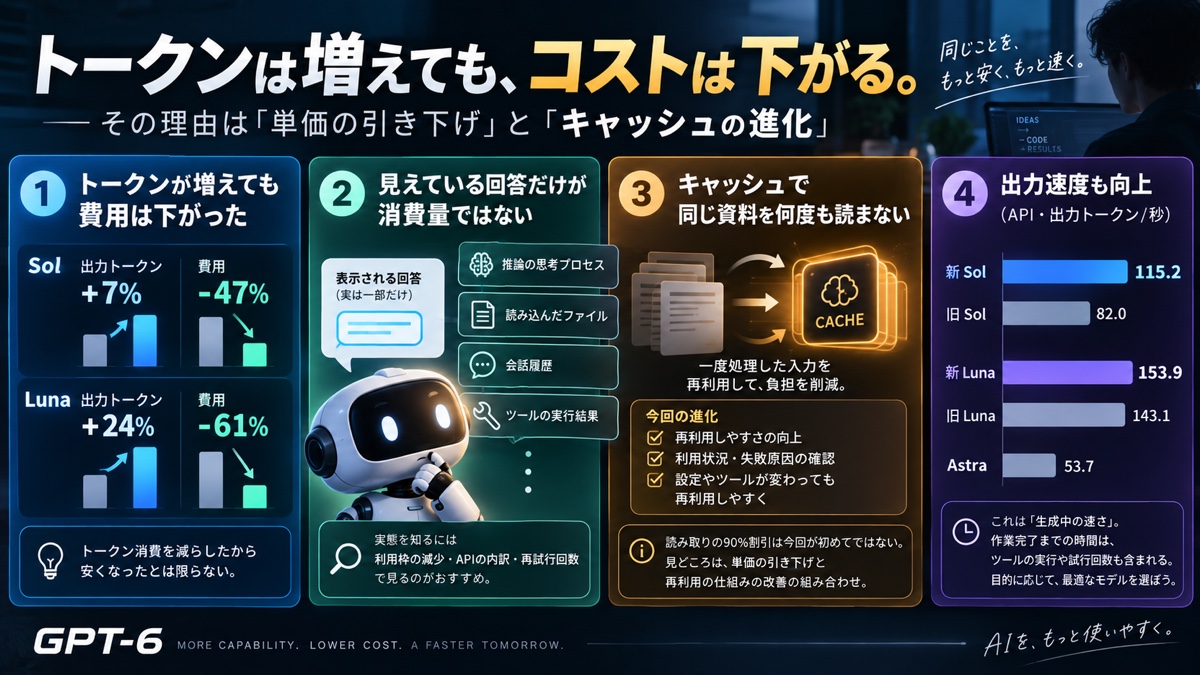
単価が下がっても、実際の請求額は処理したトークン量やキャッシュの使われ方で変わります。
独立評価では、トークンが増えても費用は下がった
今回、とくに混同したくないのがこの点です。Artificial AnalysisのIntelligence Indexでの1タスク当たりの出力トークンは、旧モデルより増えています。費用は各モデルの同指数における加重平均で、入力、キャッシュ、推論、回答の費用を含みます。[注][注][注][注][注]
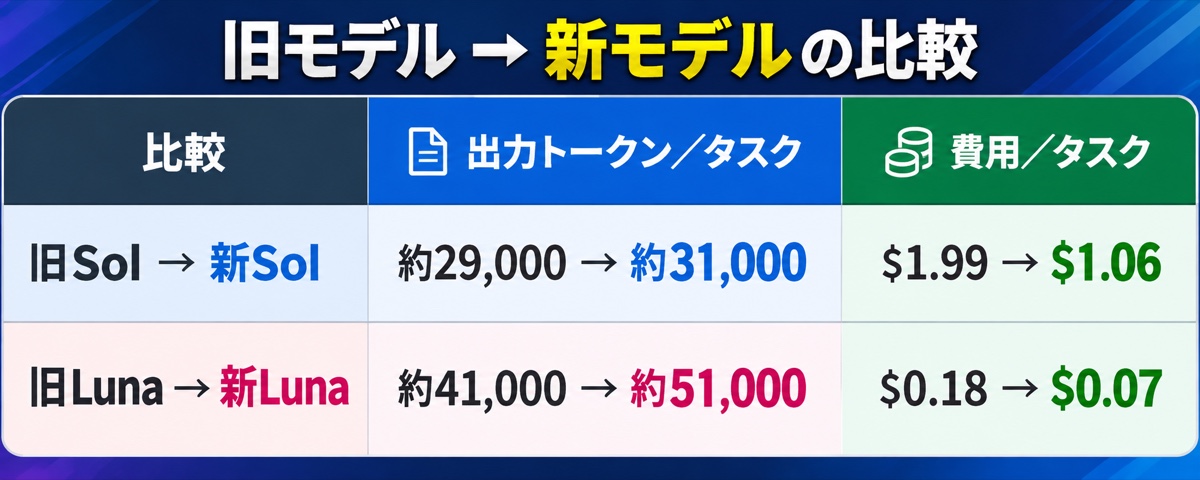
公表された丸め値から計算すると、出力トークンはSolで約7%、Lunaで約24%増。一方、費用はSolで約47%、Lunaで約61%減です。
「トークン消費を減らしたから安くなった」とは限らない。より多くのトークンを使っても、単価の引き下げによって費用が下がることがある。 この違いを押さえると、今回の更新を理解しやすくなります。
ここでの$1.06などは、あくまでその評価の1タスク当たり費用です。「Codexに1回指示すると必ず$1.06」「どのベンチマークでも同じ費用」ではありません。
画面の回答文だけが、消費量ではない
推論モデルは、最終回答を作る前の推論にもトークンを使います。APIでは、この推論トークンも出力側の課金対象です。したがって、画面に表示された回答が短くても、処理全体の出力トークンが少ないとは限りません。[注]
さらにCodexでは、指示文だけでなく、読み込んだファイル、会話履歴、ツールから戻ってきた結果なども作業量に影響します。「この1行しか指示していないのに減った」と感じても、その裏で長いコードやログを扱っていることがあります。[注]
自分の使い方を比べるなら、回答の文字数だけではなく、タスク完了までの利用枠の減少、APIの入力・出力内訳、再試行回数を見る方が実態に近づきます。
キャッシュは、同じ資料を毎回読み直す負担を減らす仕組み
たとえば、同じ仕様書や共通ルールを参照しながら、何度も修正を進める作業を考えてみてください。毎回すべてを新しく処理するのではなく、条件が合えば、すでに処理した入力の一部を再利用できます。これがプロンプトキャッシュです。[注]
GPT-6向けの改善には、再利用しやすさの向上、利用状況や失敗原因を確認する機能、推論設定やツールの利用可否を変えても以前の入力を再利用しやすくする仕組みなどがあります。[注]
ただし、キャッシュ読み取りの90%割引そのものを、今回初めて登場した特典と捉えるのは誤りです。旧モデルにも読み取り割引があります。今回の見どころは、単価の引き下げと、再利用を成立させる仕組みの改善を合わせて見たところにあります。[注][注][注]
なお、APIとCodexのクレジット課金は同じではありません。公式料金表では、Codexのクレジット課金にはAPIのような独立したキャッシュ書き込み料金はないとされています。[注]
出力速度の改善も確認。ただし「作業完了までの速さ」とは違う
Artificial Analysisのモデル別ページで確認したAPIの出力速度は、以下のとおりです。いずれも同サイトのmaxモデルの表示値で、計測時点の値です。[注][注][注][注][注]
表示値は、GPT-5.6 Solが82.0トークン/秒、新Solが115.2トークン/秒、GPT-5.6 Lunaが143.1トークン/秒、新Lunaが153.9トークン/秒、Astraが53.7トークン/秒でした。
この測定ではSolの改善幅が大きく見えます。ただし、出力速度は生成中の速さです。考え始めてから最初の回答が出るまでの時間、ツールの実行時間、試行回数まで含む「作業完了時間」とは違います。[注]
Lunaが短い部品を素早く作れても、何度も修正が必要なら、最終的にはSolの方が早く終わる可能性があります。逆に、明確な定型処理ではLunaの速さと安さが生きるでしょう。
Codexの利用枠はどう変わる? 月額料金・回数・Fastの違い
月額プランで使う場合は、API単価ではなく、モデルごとの利用枠消費と実行方式を確認します。
月額の値下げではなく、モデルによる消費の違い
Codexのクレジット料金も、新Solと新Lunaでは旧モデルより低くなっています。Standard速度での100万トークン当たりの例を、通常入力と出力に絞って示します。[注]
Standard速度の100万トークン当たりでは、GPT-5.6 Solが入力100・出力500クレジット、新Solが入力50・出力250クレジットです。GPT-5.6 Lunaは入力5・出力30クレジット、新Lunaは入力2.5・出力12.5クレジット、Astraは入力250・出力1,250クレジットです。[注]
ただし、契約に含まれる利用枠を、この表だけから正確に逆算することはできません。公式も、クレジットの単価だけでサブスクリプションの利用可能量が決まるわけではないと説明しています。[注]
5時間当たりの利用回数の目安は、どれくらい違う?
公式が掲載する「ローカルメッセージ数/5時間」の目安では、次のように差があります。個人向けの米ドル建て月額料金は、Plusが$20、Pro 5xが$100、Pro 20xが$200です。[注][注]
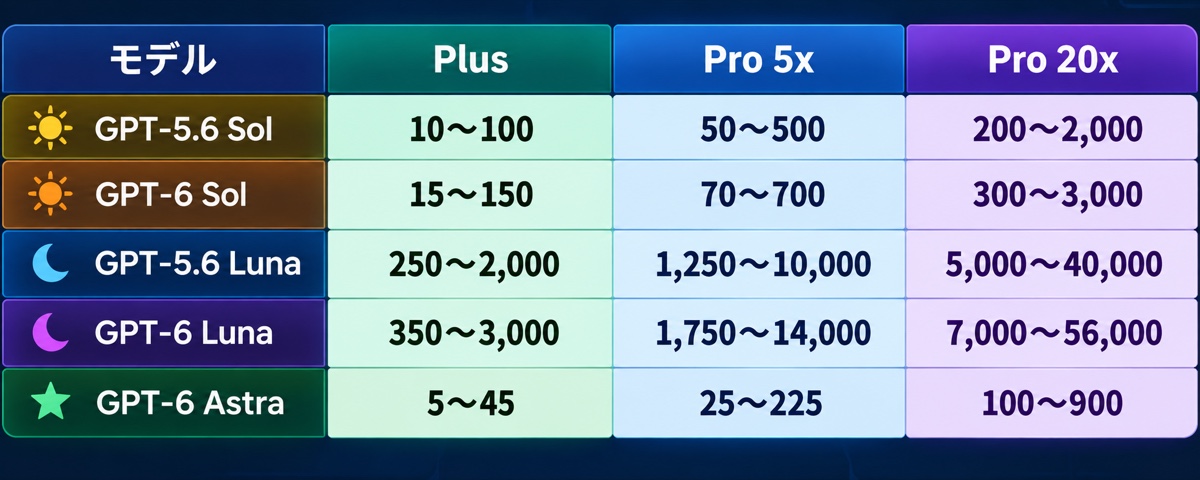
これは固定回数の保証ではありません。 軽い作業と、長いコードを調べながら何度もツールを使う作業では消費量が異なります。週単位の制限もあり、単純に「この回数まで必ず使える」「APIが半額だから利用回数も必ず2倍」とは言えません。[注]
また、CodexとChatGPT Workなどは、対象の契約で利用枠を共有します。別の機能で使った分も含め、自分のUsage画面を確認する必要があります。[注]
契約に関する補足: Proには5xと20xの区分がありますが、確認時点では月額$200のProへの新規加入・アップグレードが一時停止されています。上の表は公式掲載の利用量の比較であり、全区分へ今すぐ新規契約できるという案内ではありません。既存契約の継続とは区別してください。[注]
Fastを使うと、安くなった分以上に消費することもある
GPT-6 Astra・Sol・LunaのCodexのFastは、対応環境ではStandardの2.5倍のクレジットを消費します。APIキー利用の価格体系とは別です。[注]
同じトークン量なら、新SolのStandardは旧Solの半分のクレジットです。しかし、新SolをFastにすると、計算上は「0.5×2.5=1.25」となり、旧SolのStandardより25%多く消費する比較も成立します。
これはFastが悪いという意味ではありません。急いでいるときは、時間短縮のために利用枠を多く使う価値があります。ただ、「新モデルにしたのに利用枠が長持ちしない」と感じたら、モデル名だけでなく速度設定も確認したいということです。
CLIでは/fast statusで状態を確認し、/fast offで無効にできます。[注]
クラウド実行は、ローカルと同じ前提にしない
確認した公式料金表では、ChatGPT契約でのクラウドチャットはGPT-5.6 Solを使うとされています。したがって、今回のローカルメッセージ数の表を、すべてのクラウドタスクにそのまま当てはめることはできません。[注]
利用する画面、実行場所、ログイン方法によって前提が異なるため、実行中のモデルとUsage表示をセットで見るのが確実です。
Sol・Luna・Astraをどう使い分けるか
3モデルの使い分けは、名前や序列よりも、仕事の難しさと失敗時の影響から決めると整理しやすくなります。
迷ったらSolを基準にし、軽い仕事だけLunaへ
初心者が最初から細かい自動振り分けの仕組みを作る必要はありません。まずは普段の作業をSolで試し、仕様がはっきりした軽い仕事をLunaに移す。解決が難しい仕事ではAstraを検討するという順番が分かりやすいでしょう。
以下は、公式の位置づけと掲載した評価を踏まえた、本稿の提案です。特定のモデルでの成功を保証するものではありません。[注][注]
指定した文言の置換、整形、決まった項目の抽出は、正解や変更範囲を明確にできるならLunaから試せます。小さな修正、テスト例の作成、短いコードの説明もLunaが候補ですが、確認で詰まったらSolへ切り替えます。
ブログの表示崩れ修正や通常の機能追加、複数資料を踏まえる調査・下書きは、複数ファイルや既存仕様、必須情報の欠落まで見る必要があるためSolが基準です。原因不明の不具合や設計の見直しはSolから始め、前提の再検討や深い分析が必要ならAstraも検討します。
失敗時の影響が大きい変更ではAstraも候補になりますが、モデルの選択だけで安全性を担保せず、人が最終確認することが前提です。
「安いから全部Luna」も、「安心だから全部Astra」も、最適とは限りません。安いモデルで十分なところと、高いモデルの判断力が必要なところを分ける発想です。
ただし、要約は見た目が整っていても、重要な事実を落とすことがあります。定型的に見える仕事でも、自動で正誤を判定できるとは限らない点には注意してください。
推論設定は、いつも最低・最高に固定しない
公式ガイドは、利用中の画面で選べる標準設定から始め、難しい仕事で必要になったときに推論を深くするよう案内しています。掲載されているPowerの6段階は、Luna High、Sol Light、Sol Medium、Astra Light、Astra Medium、Astra Extra Highで、開始位置はSol Lightです。ただし、表示される選択肢や標準値はプラン、クライアント、展開状況によって異なります。[注]
したがって、「安いモデルは最低の推論設定から始めるのが絶対」「最高のMaxを選べばいつも正解」という運用にする必要はありません。まず自分の画面で選べる標準設定から試し、難しい仕事では深く、簡単な仕事では軽く調整する方が実用的です。
重要なのは、モデルの世代や種類が違うと、同じ設定名でも必要な推論量や得意な仕事が完全に一致しないことです。設定名だけで性能をそろえたつもりにならず、いつもの仕事で確かめましょう。[注]
Max・Ultra・Fastは、同じ意味ではない
Maxは1つのタスクに使う推論の深さ、Ultraは複数のサブエージェントへの分担を伴う実行、Fastは速度と利用枠の消費率を主に変えます。
LunaはMaxまで対応しますが、Ultraには対応しません。Ultraは単に「Maxよりさらに賢いモデル名」ではなく、仕事を分担して進める仕組みです。[注][注]
小さな修正に毎回Ultraを使うより、まず単独のモデルで済むかを考える。待ち時間を減らしたい場面だけFastを使う。こうして設定を分けて考えると、何に利用枠を使っているのかが見えやすくなります。
作業を分ける場合も、最初は手動で十分
たとえばWebサイトの修正なら、Solで変更方針を整理し、範囲の決まった置換や整形をLunaに任せ、最後にSolと人が変更差分や動作を確認する、といった分担が考えられます。
これは本稿の運用例であり、「今回のリリースだけで、その振り分けが常に自動実行される」という意味ではありません。普段の利用なら、モデルを手動で切り替えるだけでも比較を始められます。
Banked Resetも再配布。筆者にも今朝届いた
新モデルの発表と同時に、利用枠を後から戻せるBanked Resetの配布も案内されました。
Tibo氏がPlus・Pro・Business向けの配布を告知
モデルの発表に合わせて、Tibo氏(@thsottiaux)は、Plus・Pro・Businessの利用者のアカウントにBanked Resetを付与すると投稿しました。下の投稿画面の日時は、日本時間2026年9月23日午前3時23分です。[注][注]
筆者のアカウントにも、9月23日の朝に再びBanked Resetが届きました。新モデルを試すタイミングで、必要になったときに利用枠を回復できる手段が増えたことになります。
配布の反映時刻には差があるため、まだ見当たらない場合は、自分のアカウントのUsage画面で確認してみてください。[注]
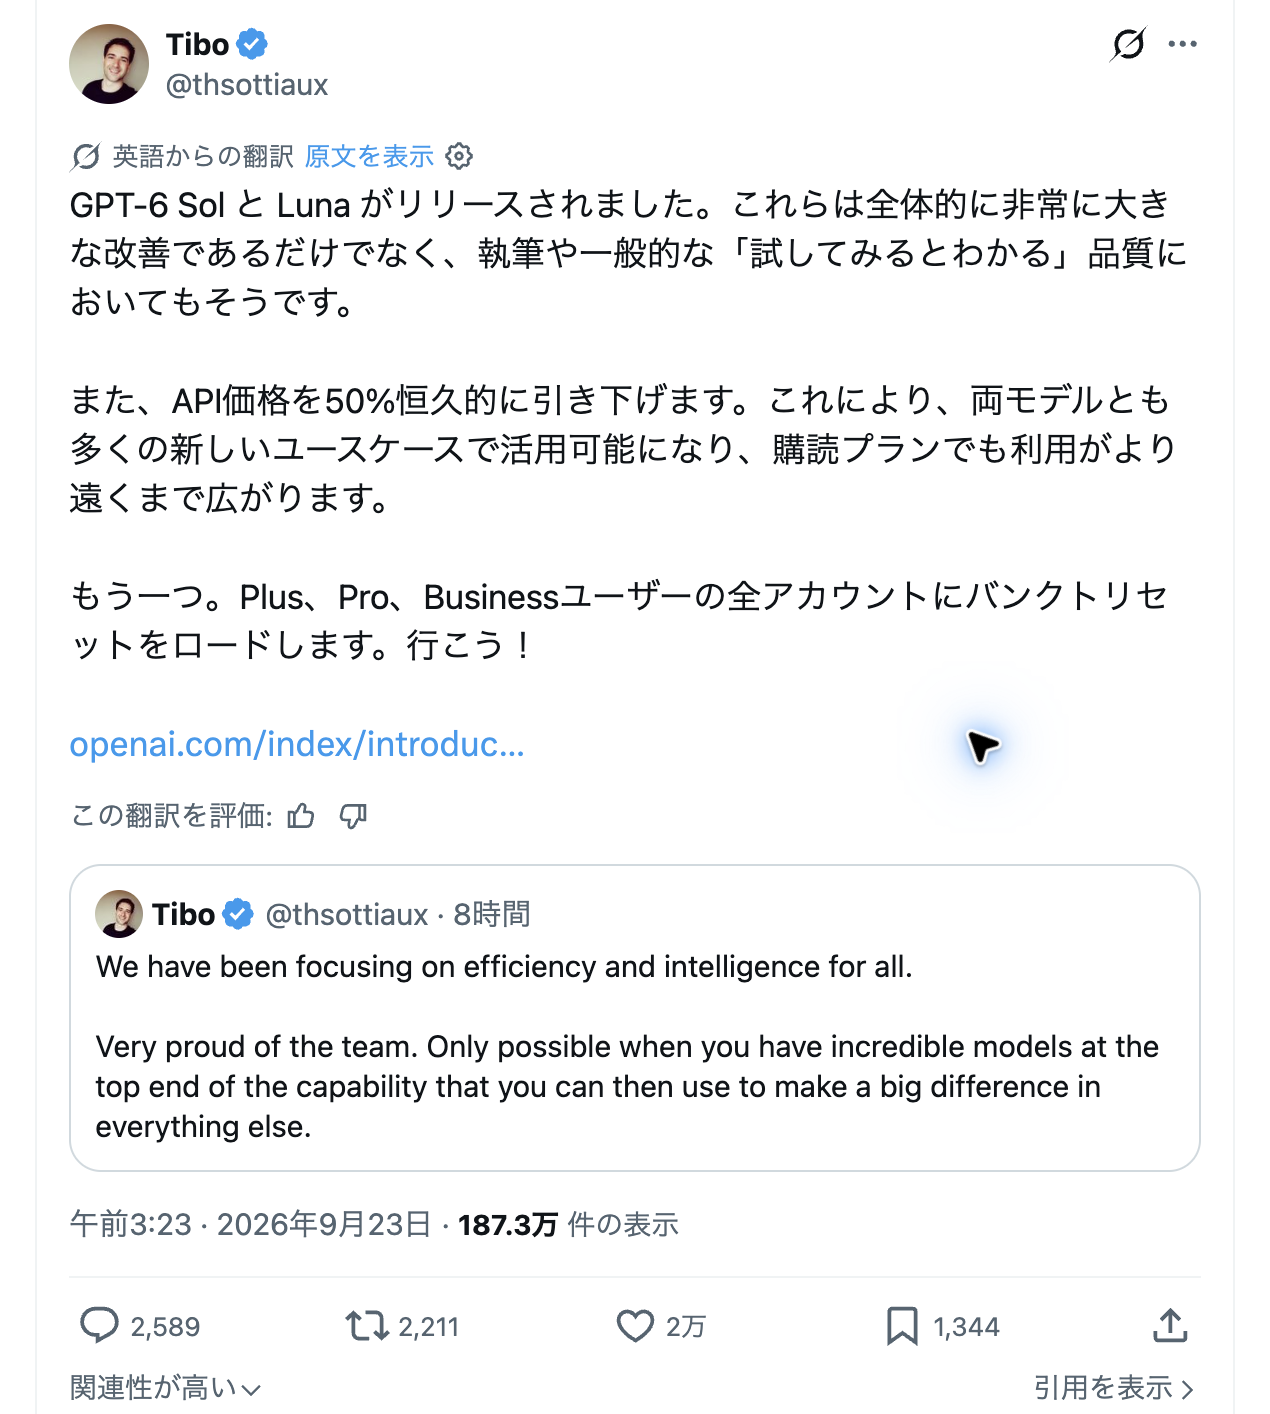
Plus・Pro・Business向けのBanked Reset配布を告知した投稿。日本時間2026年9月23日午前3時23分。これは告知の画像であり、筆者自身のUsage画面や配布完了画面ではありません。元投稿
Banked Resetは「あとで使える1回分のリセット」
Banked Resetは、アカウントに保存される、1回限りのCodex利用枠のリセットです。分かりやすくいえば「使うタイミングを選べるリセット券」に近いものです。公式ヘルプでは、Full resetで5時間枠と週単位の枠を回復すると説明されています。[注]
受け取っただけで通常の上限が永久に増えるわけではありません。また、現金やAPI用のクレジットをもらったのでもありません。利用枠を回復する仕組みとして理解するのが正確です。[注]
自動で枠が回復する一斉リセットとも違います。Banked Resetは保存して自分で適用するもの、一斉リセットは対象の枠へ直接適用されるものです。[注]
使う前に、残量と期限を確認する
公式の案内に沿った確認の流れは、次の3段階です。[注]
- 設定からUsageを開き、利用枠とリセットの残数を確認する。
- 「1 reset available」「Full reset」など、利用可能なリセットの表示を開く。
- 対象の利用枠と有効期限を確認してから適用する。
とくに確認したいのは、今どの枠が減っているのか、通常の回復時刻はいつか、リセット券はいつ失効するのかです。期限や対象条件はオファーごとに異なるため、「今回も必ず30日間使える」といった決めつけは避けましょう。[注]
今回が初めての仕組みではない
OpenAIのヘルプには、GPT-6 Astraの展開に関連して9月3日・4日に対象者へBanked Resetを配布した案内も残っています。今回のSol/Lunaで初めて導入された機能ではなく、新モデルの公開に合わせた再配布として捉えるのが適切です。[注]
なお、個人がまとめたリセット履歴は経緯を知る参考にはなりますが、通常の週次回復、即時の一斉リセット、Banked Resetが混ざる場合があります。次回の配布日時を予測するための公式スケジュールではありません。今後の配布も保証されていません。[注]
新モデルへ切り替えるときに確認したいこと
新モデルは、いきなり重要な本番作業へ固定するのではなく、普段の代表的な仕事で差を確かめます。
普段Codexを使う人は、「いつもの仕事」で比較する
最初から大量の作業を一括移行するより、完了条件が分かっている仕事で試す方が、違いを判断しやすくなります。たとえば、同じ不具合の修正、決まった形式のデータ整理、過去に作った機能の小規模な改良などです。
比較するときは、モデル名に加えて推論設定とFastの有無を記録します。旧モデルが途中まで直した状態から新モデルを試すのではなく、同じ元の状態から始めると、条件をそろえやすくなります。
確認する項目は、次の3つに絞ると続けやすいでしょう。
- 品質: 必須条件を満たし、余計な変更をせず、テストや確認を通ったか。
- 時間: 指示してから、修正を終えて採用できるまで何分かかったか。
- 負担: 利用枠・API費用、やり直し回数、人の確認時間はどう変わったか。
「最初の回答が速かった」「その場では安かった」だけでなく、完成までを見るための比較です。
切り替え方は、利用する画面に合わせる
Codex CLIでは、会話中に/modelを使ってモデルや推論設定を変更できます。起動時に指定する場合は、たとえばcodex -m gpt-6-solです。デスクトップアプリなどでは、モデル選択欄を確認します。[注]
APIで呼び出すプログラムでは、公式のモデルIDはgpt-6-solとgpt-6-lunaです。新モデルでは、使うAPIの種類と推論設定によってツール呼び出しの対応条件があるため、モデル名だけを書き換えず、利用している方式も確認してください。組み込みツールや推論付きの関数呼び出しでは、Responses APIの仕様を確認するのが基本です。[注][注]
自動処理なら、小さく試してから広げる
既存の自動処理を持っている場合は、まずモデル指定を洗い出し、切り戻せる状態にしてから変更します。最初の点検用として20〜50件程度の代表的な入力を選ぶ方法はありますが、この件数だけで品質を統計的に保証できるわけではありません。重要な用途ほど、例外的な入力や失敗しやすい条件も追加したいところです。
確認したいのは、文章の良し悪しだけではありません。必要な項目が欠けていないか、JSONなど指定形式を守っているか、後続の処理が正しく読めるか、エラー時に際限なく再試行しないかも見ます。
安いモデルが1回で完璧に答えなければ、その時点で節約失敗というわけでもありません。多少の再試行があっても安く済むことはあります。逆に、API料金だけ下がっても、人の修正時間が大きく増えれば、使い方として得とは限りません。
比べるべきなのは、「許容できる品質の仕事を1件完成させるまでの総負担」です。
まとめ:安さだけでなく「完成までの負担」で選ぶ
GPT-6 SolとLunaの登場は、Codexで高性能モデルを使い続ける費用や利用枠を見直すきっかけになります。しかし、価格、トークン量、ベンチマークの点数は、それぞれ別の指標です。
新Solは、普段の開発を任せる中心候補。Lunaは、範囲を決めた仕事を速く安く回す候補。Astraは、難しい判断に深く取り組みたいときの候補。このように役割を分けて考えると、「全部いちばん高いモデル」「全部いちばん安いモデル」の二択から離れられます。
今回配布されたBanked Resetも、必要なタイミングで新モデルを試す助けになります。ただ、リセット券が届いたからといって、使い慣れた処理を一度に置き換える必要はありません。
まずは、いつもの仕事を一つ選ぶ。必要な品質を保てるか、完成まで何分かかるか、利用枠はどのくらい減るかを確かめる。その結果でモデルを選ぶことが、今回の更新を自分の仕事に生かすいちばん確かな方法です。
#AI #生成AI #ChatGPT #Codex #GPT6
出典・参考資料
以下は2026年9月23日に確認した資料です。モデル別ページや料金表は更新されるため、実際に利用する際は現在の表示も確認してください。本文の表は、掲載条件をそろえられる範囲で抜粋・再構成しています。
[注] OpenAI「Introducing GPT-6 Sol and Luna」。公開内容、提供範囲、DeepSWE・FrontierCode・Agents’ Last Exam・OSWorld、事実性評価および測定条件。https://openai.com/index/introducing-gpt-6-sol-and-luna/
[注] OpenAI Help Center「Using Codex with your ChatGPT plan」。Codexの概要、契約での利用、利用量に影響する要因、共有利用枠。https://help.openai.com/en/articles/11369540-using-codex-with-your-chatgpt-plan
[注] OpenAI「Models | ChatGPT Learn」。モデルの位置づけ、CLIでの選択、推論設定、Max・Ultra、Lunaの対応範囲。https://learn.chatgpt.com/docs/models
[注] OpenAI API「GPT-6 Sol Model」。入力・キャッシュ・出力料金、長文加算、推論とAPIの対応条件。https://developers.openai.com/api/docs/models/gpt-6-sol
[注] OpenAI API「GPT-6 Luna Model」。入力・キャッシュ・出力料金、長文加算、推論とAPIの対応条件。https://developers.openai.com/api/docs/models/gpt-6-luna
[注] OpenAI API「GPT-6 Astra Model」。位置づけ、料金、仕様。https://developers.openai.com/api/docs/models/gpt-6-astra
[注] OpenAI API「GPT-5.6 Sol Model」。旧世代の比較用料金。https://developers.openai.com/api/docs/models/gpt-5.6-sol
[注] OpenAI API「GPT-5.6 Luna Model」。旧世代の比較用料金。https://developers.openai.com/api/docs/models/gpt-5.6-luna
[注] OpenAI Help Center「Understanding and counting tokens」。トークンの説明と数え方。https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
[注] Zapier「AutomationBench」。バージョン1.0.6の公開スコア、タスク費用、判定方法。https://zapier.com/benchmarks
[注] Artificial Analysis「GPT-6 Sol and Luna push the cost efficiency frontier」(2026年9月22日)。Codex実行環境での新旧比較、1タスク当たり出力トークン、知識問題の回答傾向、改善・後退の分析。https://artificialanalysis.ai/articles/gpt-6-sol-and-luna-push-the-cost-efficiency-frontier
[注] Artificial Analysis「GPT-6 Sol (max)」。Intelligence Index、出力速度、同指数のタスク費用。https://artificialanalysis.ai/models/gpt-6-sol
[注] Artificial Analysis「GPT-6 Luna (max)」。Intelligence Index、出力速度、同指数のタスク費用。https://artificialanalysis.ai/models/gpt-6-luna
[注] Artificial Analysis「GPT-5.6 Sol (max)」。新旧比較用のIntelligence Index、出力速度、同指数のタスク費用。https://artificialanalysis.ai/models/gpt-5-6-sol
[注] Artificial Analysis「GPT-5.6 Luna (max)」。新旧比較用のIntelligence Index、出力速度、同指数のタスク費用。https://artificialanalysis.ai/models/gpt-5-6-luna
[注] Artificial Analysis「GPT-6 Astra (max)」。Intelligence Index、出力速度、指標の定義。https://artificialanalysis.ai/models/gpt-6-astra
[注] Anthropic「Claude Opus 5.5」(2026年9月22日)。同時期の競合モデルの公開を確認。https://www.anthropic.com/claude-opus-5-5
[注] OpenAI API「Reasoning models」。推論トークンの課金と出力トークン上限。https://developers.openai.com/api/docs/guides/reasoning
[注] OpenAI API「Prompt caching」。キャッシュ読み取り・書き込みの料金と仕組み。https://developers.openai.com/api/docs/guides/prompt-caching
[注] OpenAI「Better prompt caching for GPT-6」(2026年9月22日)。キャッシュの再利用、診断、設定変更への対応。https://openai.com/index/better-prompt-caching-for-gpt-6/
[注] OpenAI「Pricing | ChatGPT Learn」。ローカルメッセージ数の目安、クレジット単価、キャッシュ書き込みの扱い、クラウドチャットのモデル。https://learn.chatgpt.com/docs/pricing
[注] OpenAI Help Center「About ChatGPT Pro tiers」。Proの区分と月額$200プランの新規加入・アップグレードの一時停止。https://help.openai.com/en/articles/9793128-about-chatgpt-pro-plans
[注] OpenAI「Speed | ChatGPT Learn」。Fastのクレジット倍率、APIキー利用との区別、CLIコマンド。https://learn.chatgpt.com/docs/agent-configuration/speed
[注] Tibo(@thsottiaux)のGPT-6 Sol/LunaおよびBanked Reset配布告知。投稿URLと添付画面の内容を照合。https://x.com/thsottiaux/status/2102463847714247142
[注] 筆者提供の投稿画面「スクリーンショット 2026-09-23 10.19.58.png」。日本時間9月23日午前3時23分の表示と、Plus・Pro・Business向けのBanked Reset配布文言を確認。筆者自身が朝に受け取った事実とは別の資料。
[注] OpenAI Help Center「How banked Codex resets work」。保存型リセットの定義、適用手順、回復対象、期限、Astra展開時の配布例。https://help.openai.com/en/articles/20001498-how-banked-codex-resets-work
参考として提供された個人の記録
ついはじめ氏(@hajimetwi3)の当日メモ。元投稿ページの本文は直接取得できなかったため、提供された3枚のスクリーンショットで内容を確認しました。リセット履歴・当日の観測を知る参考資料として扱い、公式の配布完了時刻や次回配布の保証には使用していません。 https://x.com/hajimetwi3/status/2102493170189914159
コメント