「少し修正を頼んだだけなのに、もう利用制限?」「でも、ルールを減らしたら、前の失敗を繰り返しそう」。AIを仕事に使うほど、気になる問題です。
見直したいのは、依頼文の短さだけではありません。大切なのは、成果物ができるまでに、何を読ませ、どこまで任せ、何回やり直しているかです。
この記事では、CodexやClaude CodeなどのAIエージェントを中心に、必要な指示を残したまま無駄を減らす方法を紹介します。資料の絞り方や依頼の組み立て方は、通常のチャットにも応用できます。仕様は2026年9月8日に公式情報を確認しました。本文の分類、点検プロンプト、比較方法は、公式の必須形式や削減効果の実測値ではなく、確認した仕様をもとにした実践例です。
まず、トークン・コンテキスト・利用枠を区別する
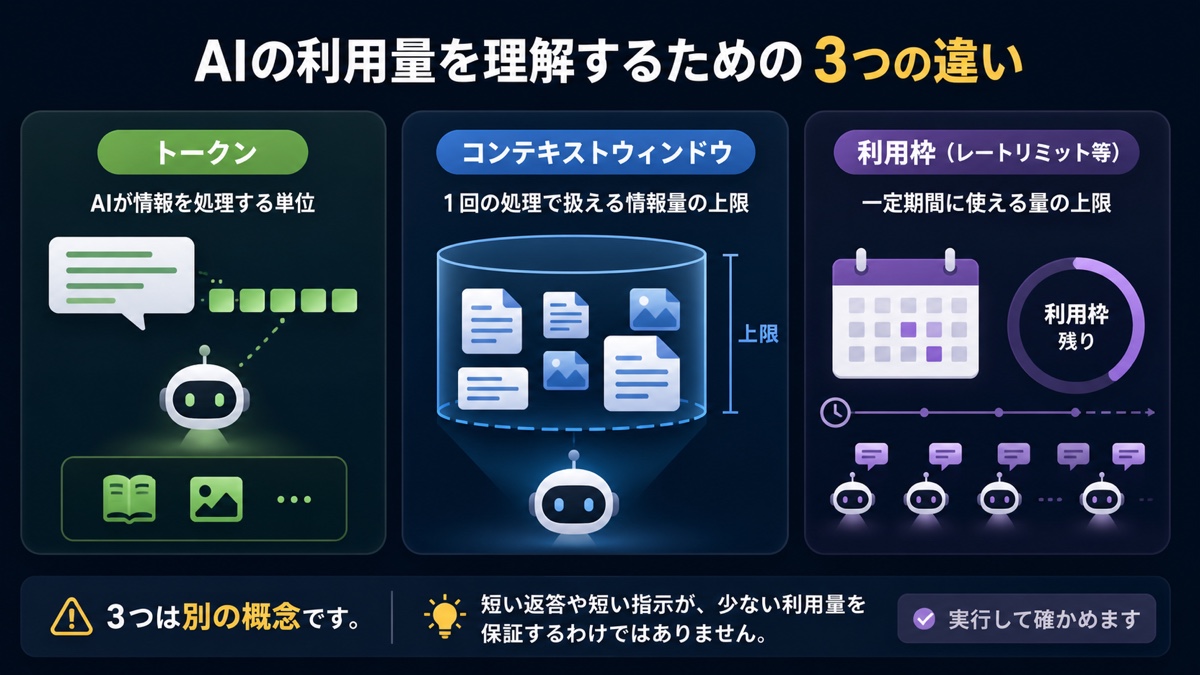
トークンは、AIが情報を処理するときの単位です。入力した文章だけでなく、参照資料、会話履歴、ツールの実行結果、AIの出力も処理の対象になります。推論モデルでは、画面に表示されない推論トークンも使われるため、返答が短ければ処理量も必ず少ないとは限りません。[1][2]
コンテキストウィンドウは、1回の処理で扱える情報量の上限です。一定期間の利用枠やAPIの請求額とは別なので、コンテキストを空けても、使い切った利用枠が戻るわけではありません。まず使用量画面やCLIの/statusで、どの上限に達したのか、リセット時刻があるのかを確認しましょう。[2]
ここで避けたいのが、「指示書を半分の文字数にしたから、利用枠も半分しか消費しなくなる」という計算です。文字数とトークン数は一致せず、利用量にはモデル、推論、ツール利用、検索、キャッシュなども影響します。文字数の削減は整理の結果、利用枠の節約は実行して確かめる結果として分けて扱います。[1][2]
APIには、共通する入力の処理結果を再利用し、入力コストや待ち時間を抑える「プロンプトキャッシュ」もあります。ただし適用には条件があり、情報がコンテキストから消える仕組みではありません。APIのキャッシュ割引と、ChatGPTなど月額サービスの利用枠も同じものではありません。[3]
Codexの利用状況表示やリセットの考え方は、Codexの5時間枠と週次枠を整理した記事でも詳しく解説しています。
依頼を短くする前に、完了条件を決める
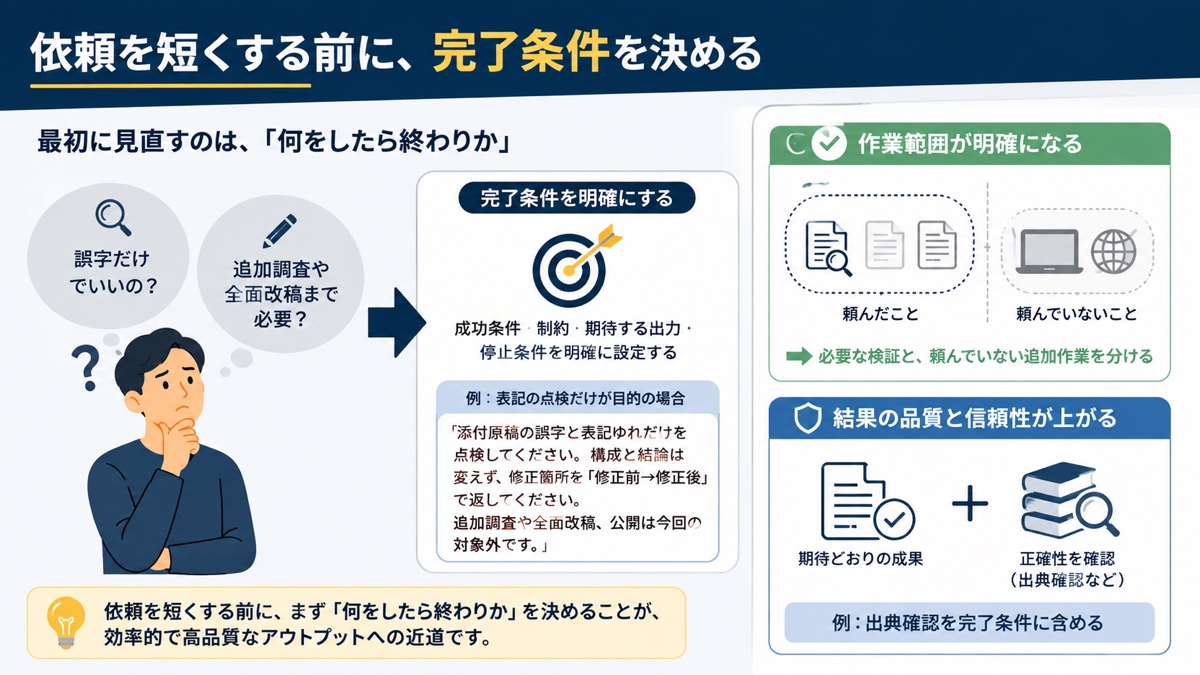
最初に見直すのは、「何をしたら終わりか」です。「この原稿をもっとよくして」では、誤字修正でよいのか、追加調査や全面改稿まで必要なのかが定まりません。OpenAIのモデル向けガイドでも、成功条件、制約、期待する出力、停止条件を明確にすることが勧められています。[4]
たとえば、表記の点検だけが目的なら、次のように頼めます。
添付原稿の誤字と表記ゆれだけを点検してください。構成と結論は変えず、修正箇所を「修正前→修正後」で返してください。追加調査や全面改稿、公開は今回の対象外です。
依頼文が多少長くなっても、作業範囲は明確になります。記事の正確性を確認したい場面なら、出典確認を完了条件に含めます。これは、必要な検証と、頼んでいない追加作業を分ける考え方です。
指示書は「常時読むもの」と「作業時に読むもの」に分ける
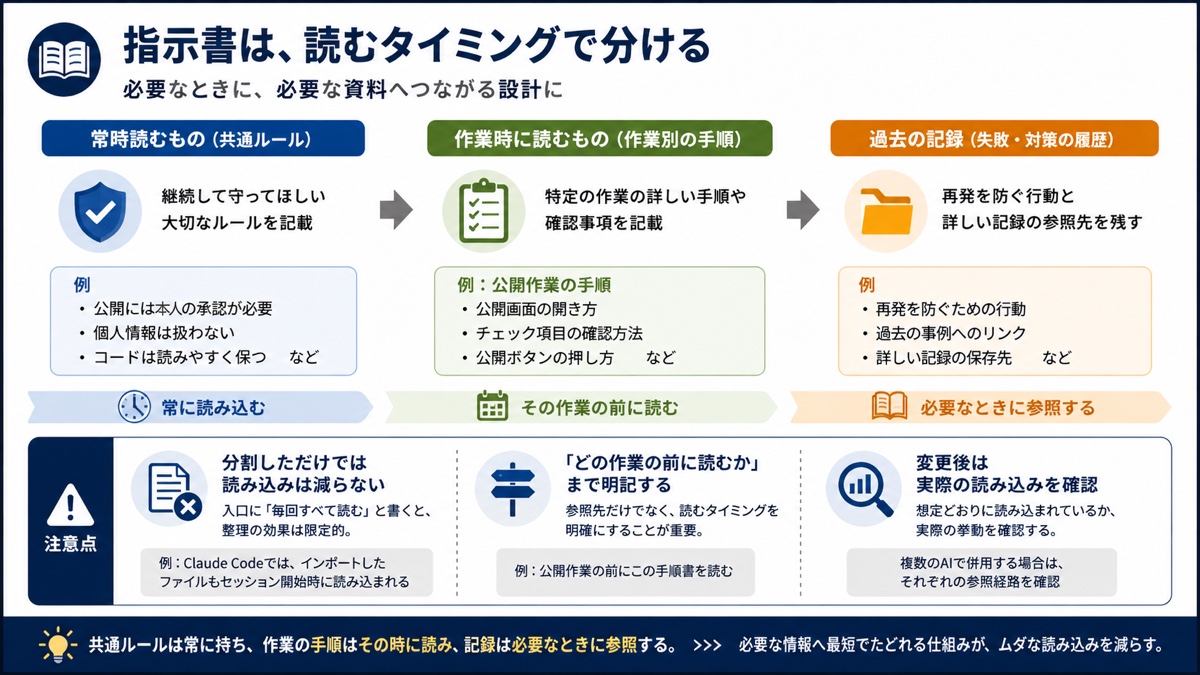
大切なルールではなく、読むタイミングを整理する
CodexのAGENTS.mdやClaude CodeのCLAUDE.mdは、継続して守ってほしい指示を伝えるファイルです。ただし、読み込まれる範囲や順序は環境によって異なります。[5][6]
共通する考え方は、無関係な仕事の詳しい説明まで常時持たせず、必要な仕事で必要な資料へたどれるようにすることです。Anthropicは、頻繁に使う指示をCLAUDE.mdへ残し、特定業務の詳しい手順は必要時に読み込むSkillsへ置く方法を案内しています。[6]
以下は、公式の必須構成ではなく、運用を整理するための設計例です。
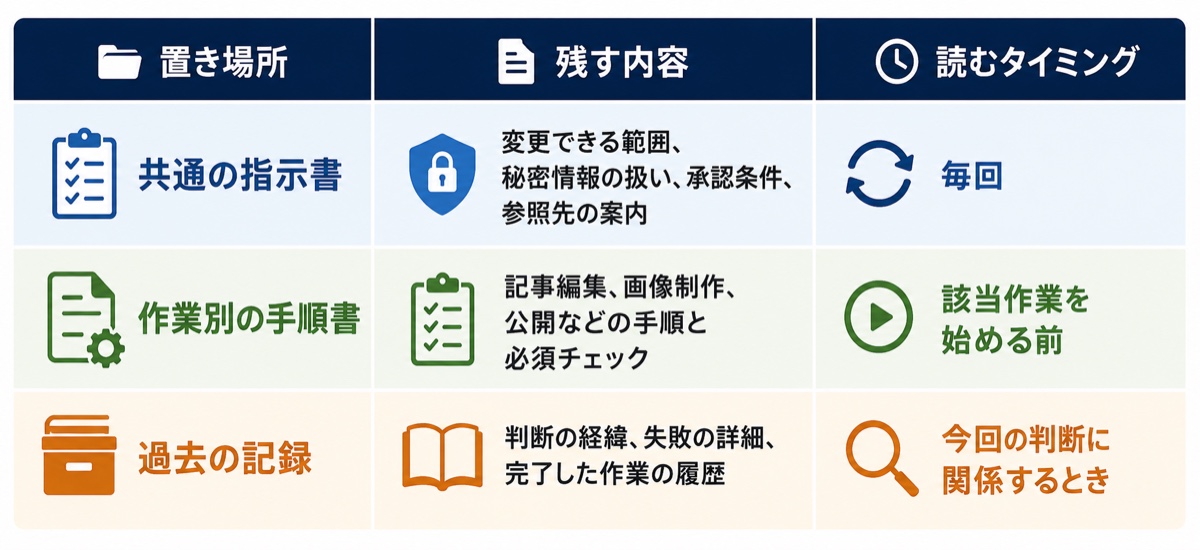
たとえば「公開には本人の承認が必要」は共通に残し、公開画面で確認する細かな手順は、公開作業の前に読む資料へ移します。失敗対策も、長い事故記録を毎回読む代わりに、再発を防ぐ行動と詳しい記録の参照先を残す方法があります。
分割しただけでは、読み込みは減らない
別ファイルへ移しても、入口に「毎回すべて読む」と書けば整理の効果は限られます。Claude Codeでは、CLAUDE.mdからインポートしたファイルもセッション開始時に読み込まれるため、ファイル分割と必要時読み込みは同じではありません。[6]
参照先だけでなく「どの作業の前に読むか」まで明記し、変更後は実際の読み込みを確認します。複数のAIで併用する場合も、それぞれの参照経路を確かめてください。[5][6]
過去ログは消さずに、現在地からたどれる形にする
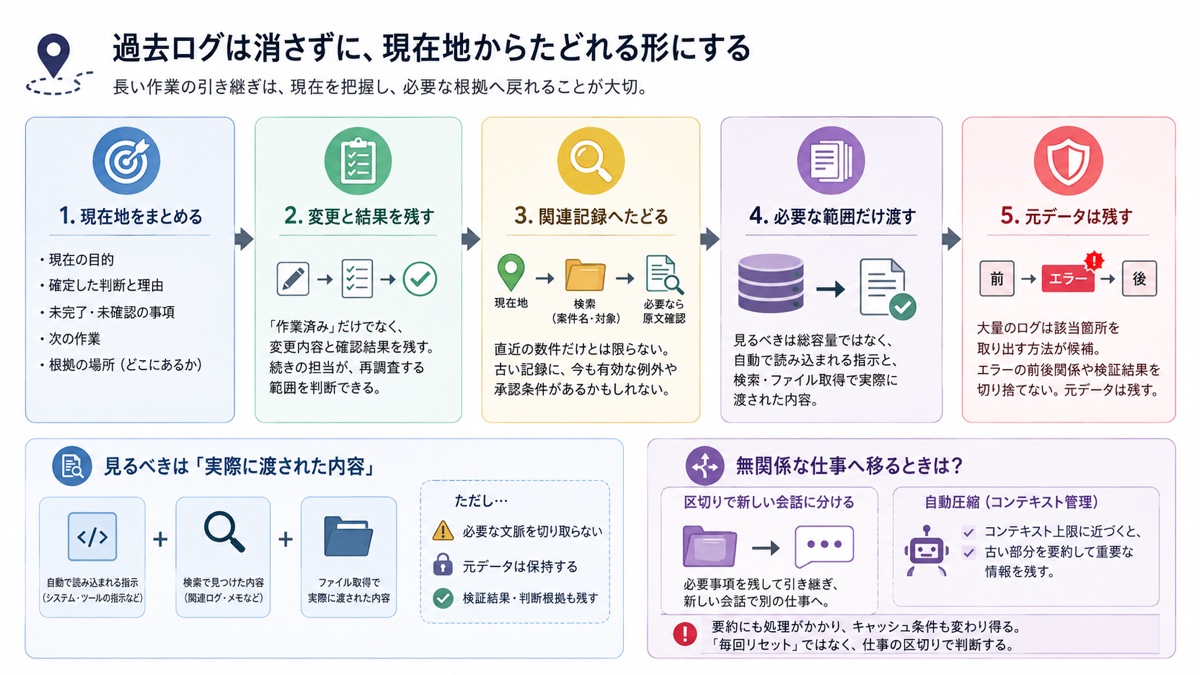
長い作業を引き継ぐときは、履歴をすべて読むより、現在の状態を把握し、必要な根拠へ戻れる形を目指します。
引き継ぎメモには「現在の目的」「確定した判断と理由」「未完了・未確認の事項」「次の作業」「根拠の場所」をまとめます。「作業済み」だけでなく、変更内容と確認結果を残せば、続きの担当も再調査する範囲を判断できます。
ただし、「直近の数件だけ読めば十分」とは限りません。古い記録に、今も有効な例外や承認条件があるかもしれないからです。現在地を読み、案件名や対象ファイルで関連記録を探し、必要なら原文まで確認する順番にします。
見るべきなのはフォルダの総容量ではなく、自動で読み込まれる指示と、検索・ファイル取得で実際に渡された内容です。大量のログは該当箇所を取り出す方法が候補になりますが、エラーの前後関係や検証結果を切り捨てないよう、元データは残します。[2][5][7]
無関係な仕事へ移るときは、必要事項を残して新しい会話に分ける方法もあります。Claude Codeはコンテキスト上限へ近づくと古い部分を要約し、重要な情報を残す自動圧縮を行うと説明しています。ただし要約にも処理がかかり、キャッシュ条件も変わり得るため、「毎回リセット」ではなく仕事の区切りで判断します。[3][7]
モデル選びと分担は、結果を検証できる作業から
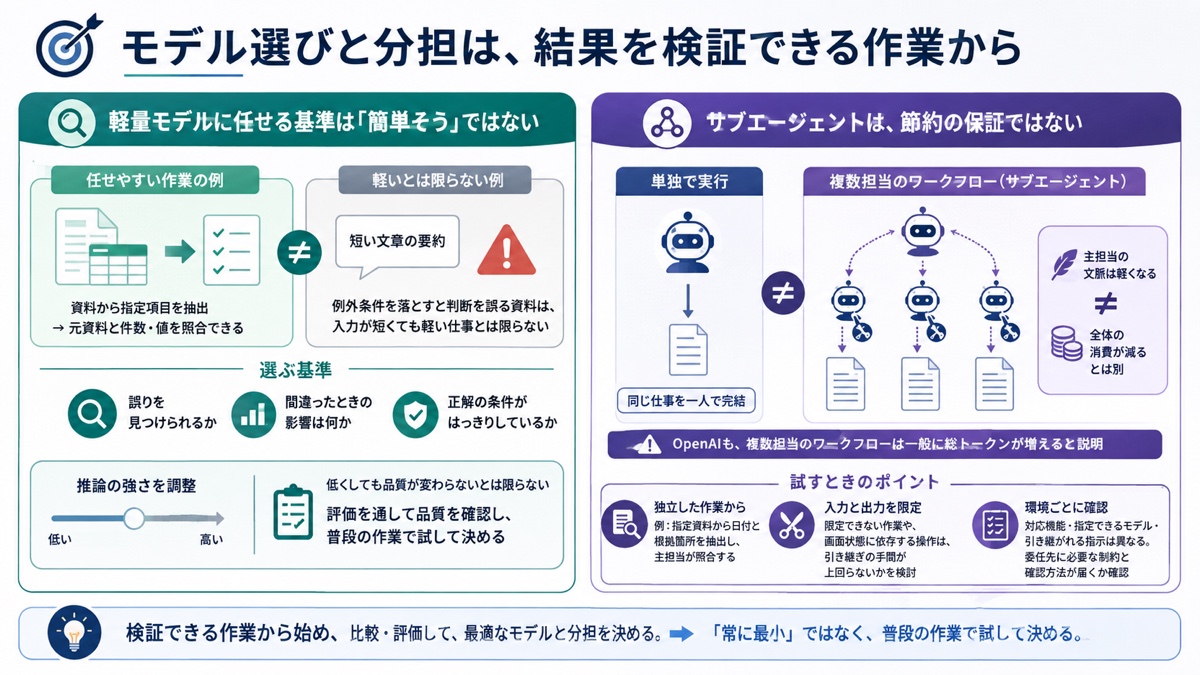
軽量モデルに任せる基準は「簡単そう」ではない
軽量モデルを試すなら、正解の条件がはっきりしていて、出力を確かめやすい仕事から始めます。[2]
たとえば、資料から指定項目を抜き出し、元資料と件数・値を照合できる作業です。一方、「短い文章の要約」でも、例外条件を落とすと判断を誤る資料なら、軽い仕事とは限りません。入力の短さより、誤りを見つけられるか、間違ったときの影響は何かで選びます。
対応環境では、モデルを替えずに推論の強さを調整する方法もあります。低い設定でも品質が変わらないとは限らないため、Anthropicの公式資料でも、評価を通して品質を確認する考え方が示されています。「常に最小」ではなく、普段の作業で試して決めます。[8]
サブエージェントは、節約の保証ではない
サブエージェントは、主担当のAIが別のAIに作業の一部を任せる仕組みです。主担当へ大量の中間ログを持たせずに済む反面、各担当が個別にモデルとツールを使います。OpenAIも、同様の仕事を単独で実行する場合と比べ、複数担当のワークフローは一般に総トークンが増えると説明しています。主担当の文脈が軽くなることと、全体の消費が減ることは別です。[9]
軽量モデルへの分担でコストを抑えられる可能性はありますが、主担当の確認も含めて比較します。試すなら「指定資料から日付と根拠箇所を抽出し、主担当が照合する」など、入力と出力を限定できる独立した作業から始めます。少しの修正や、直前の画面状態に依存する操作は、引き継ぎの手間が上回らないかを考えます。[9][10]
対応機能や指定できるモデル、引き継がれる指示は環境によって異なります。委任先へ必要な制約と確認方法が届くかも確認してください。[9][10]
自分の環境を点検するプロンプト
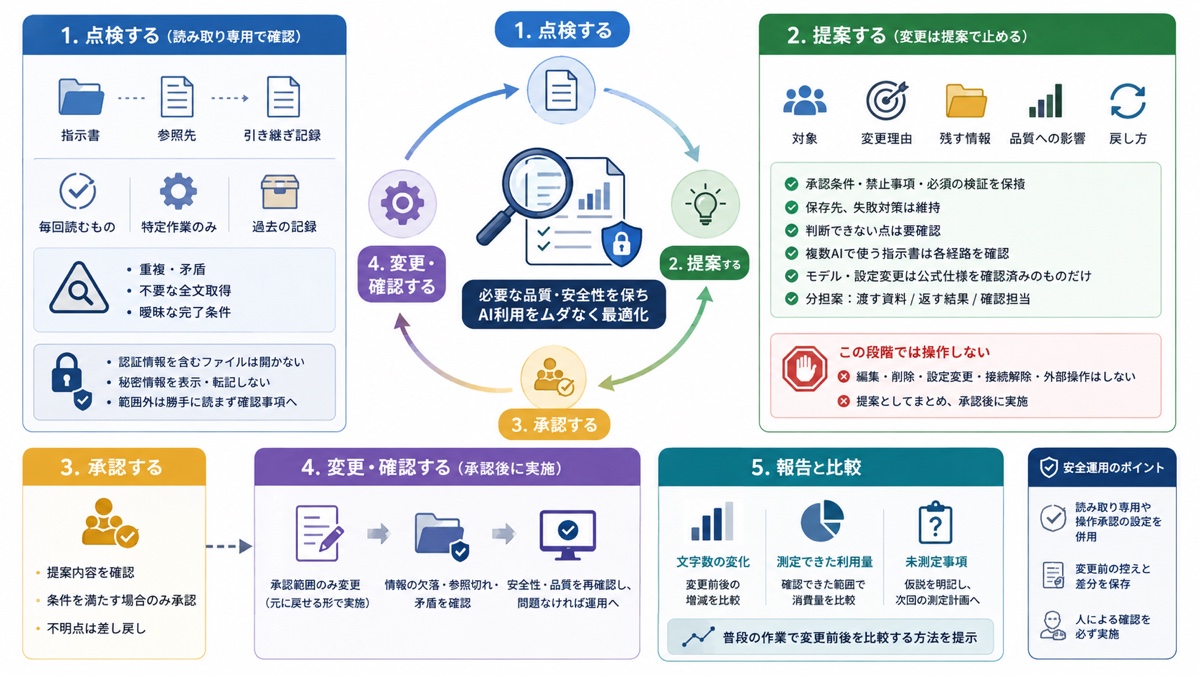
以下は本記事用の点検例で、公式配布や削減効果を保証するプロンプトではありません。ファイルにアクセスできない環境では、提供資料の範囲で提案を受けます。
AIの利用量を、必要な品質と安全性を保ちながら見直したいです。対象は、私が指定した作業フォルダと添付資料です。

まず読み取り専用で、指示書、参照先、引き継ぎ記録の読み込み経路を必要な範囲だけ確認してください。認証情報を含むファイルは開かず、秘密情報を表示・転記しないでください。参照先が対象範囲外なら、勝手に読まず確認事項にしてください。

毎回読み込む内容、特定の作業だけで必要な内容、過去記録を分け、重複、矛盾、不要な全文取得、曖昧な完了条件を探してください。実際の利用ログを確認できない場合、消費の原因は仮説と明記してください。

変更案ごとに、対象、変更理由、残す情報、品質への影響、戻し方を示してください。承認条件、禁止事項、必須の検証、保存先、現在も有効な失敗対策は保持し、判断できないものは要確認にしてください。複数のAIで使う指示書は、それぞれの参照経路を確認してください。

モデルや推論設定、サブエージェントの変更は、現在の公式仕様で対応を確認できた場合だけ提案してください。分担案には、渡す資料、返す結果、確認担当を含めてください。

この段階では編集・削除・設定変更・接続解除・外部操作をせず、提案で止めてください。私が承認した後だけ、その範囲を元に戻せる形で変更し、情報の欠落、参照切れ、矛盾を確認してください。

最後に、文字数の変化、測定できた利用量、未測定事項を分けて報告し、普段の作業で変更前後を比較する方法を示してください。
「承認後に変更」と書くだけで操作ミスを完全に防げるわけではありません。利用環境に読み取り専用や操作承認の設定がある場合は併用し、変更前の控えと差分を人も確認します。
まとめ|効果は、やり直しまで含めて確かめる
見直し後は、よく行う作業を同じ素材と完成条件で比較します。指示書の整理を試すときはモデルを変えず、モデル選びを試すときは資料の渡し方をそろえるなど、変更点を分けると原因を追いやすくなります。
記録するのは、確認できる範囲の利用枠の消費やAPI料金、完了までの時間、修正回数、必要なチェックを通ったかです。APIのトークン数を見るなら入力、出力、キャッシュを区別し、利用枠しか表示されない環境では、分からないトークン数を推測で埋めません。[1][2]
1回目の回答が安くても、修正を重ねれば得とは限りません。目標は、いちばん短い指示書を作ることではなく、必要な品質の成果物を、少ない手戻りで完成させることです。
まずは、毎回読ませている資料の中から、今回の仕事には関係しないものを1つ見つけるところから始めてください。
参考資料
確認日:2026年9月8日。本文中の番号は、対応する公式資料を示しています。
[1] OpenAI「Understanding and counting tokens」
[2] OpenAI「Pricing」
[3] OpenAI「Prompt caching」
[4] OpenAI「Using GPT-5.4」
[5] OpenAI「Custom instructions with AGENTS.md」
[6] Anthropic「How Claude remembers your project」
[7] Anthropic「How Claude Code works」
[8] Anthropic「Effort」
[9] OpenAI「Subagents」
[10] Anthropic「Create custom subagents」
#AI活用 #Codex #ClaudeCode #トークン節約 #AITryLab

コメント