AIに仕事を任せるとき、気になるのは返答の賢さだけではありません。何度も修正を頼み、資料を調べ直し、ようやく仕上がりに近づいたところで利用枠が尽きる。そんな使い方では、「同じ契約で、どこまで作業を進められるか」が重要になります。
前回のDAY11は、モデルの混雑エラーを減らし、発生しても処理を続けやすくする改善でした。続くDAY12は、CodexとWorkで、実質的に使える量を増やす更新です。サブエージェント間での文脈の再利用、キャッシュの保持時間延長、リクエストの振り分け改善が発表されています。1
同時期には、ChatGPTのGPT-6 Astra Proで高速化と並列作業、ChatGPT Spaceでスライド対応も案内されました。今回は、それぞれ何が変わるのかを日本語訳で確認しながら、「AIを増やして働かせること」と「無駄な処理を減らすこと」が、なぜセットで重要なのかまで見ていきます。23
DAY12は、利用枠の「量」より「使い方」を改善
DAY12で示されたのは、使った分を戻すリセットではありません。発表の中心は、処理の重複を減らすことで、CodexとWorkから得られる実質的な利用量を増やすことです。1
投稿の日本語訳
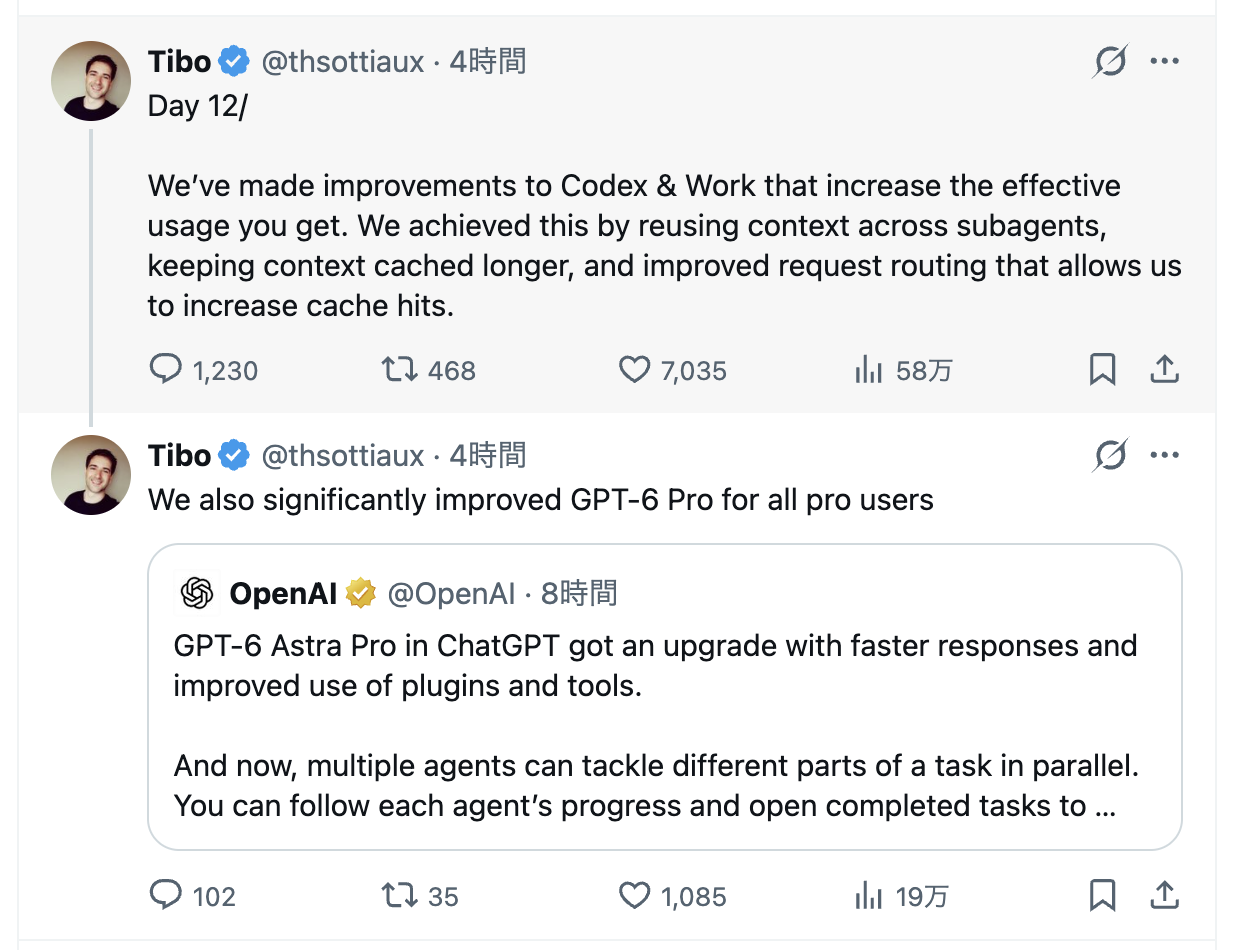
図1:CodexとWorkの実効利用量改善を説明するDAY12の投稿。下部にはGPT-6 Proに関する補足返信も見える。2026年10月17日の投稿画面。1
DAY12の投稿・日本語訳
12日目。
CodexとWorkを改善し、実質的に利用できる量を増やしました。サブエージェント間でコンテキストを再利用し、コンテキストをキャッシュに保持する時間を延ばし、キャッシュを再利用できる割合を高めるようリクエストの振り分けを改善することで実現しました。
出典:Tibo(@thsottiaux)の投稿。日本語訳は図1の原文に基づく。1
「週の上限を増やした」とは、少し意味が違う
ここでのポイントは、利用枠を増やす方法には、枠そのものを大きくする方法と、同じ仕事で使う量を減らす方法があることです。DAY12の説明は後者に当たります。「同じ枠から、より多くの仕事を引き出しやすくする」と捉えると分かりやすいでしょう。
ただし、今回の投稿には「何%増える」「すべてのプランで上限が2倍になる」といった数値や条件は示されていません。キャッシュの具体的な保持時間や、モデル・プラン別の効果も未公表です。したがって、今回の更新をそのまま契約上の上限引き上げや無制限化と読むことはできません。1
長い背景資料を繰り返し使う仕事と、毎回まったく違う短い質問をする使い方では、再利用できる部分が違います。改善の意味をつかむには、まず「何を使い回すのか」を見る必要があります。
同じ背景を何度も処理しない、3つの工夫
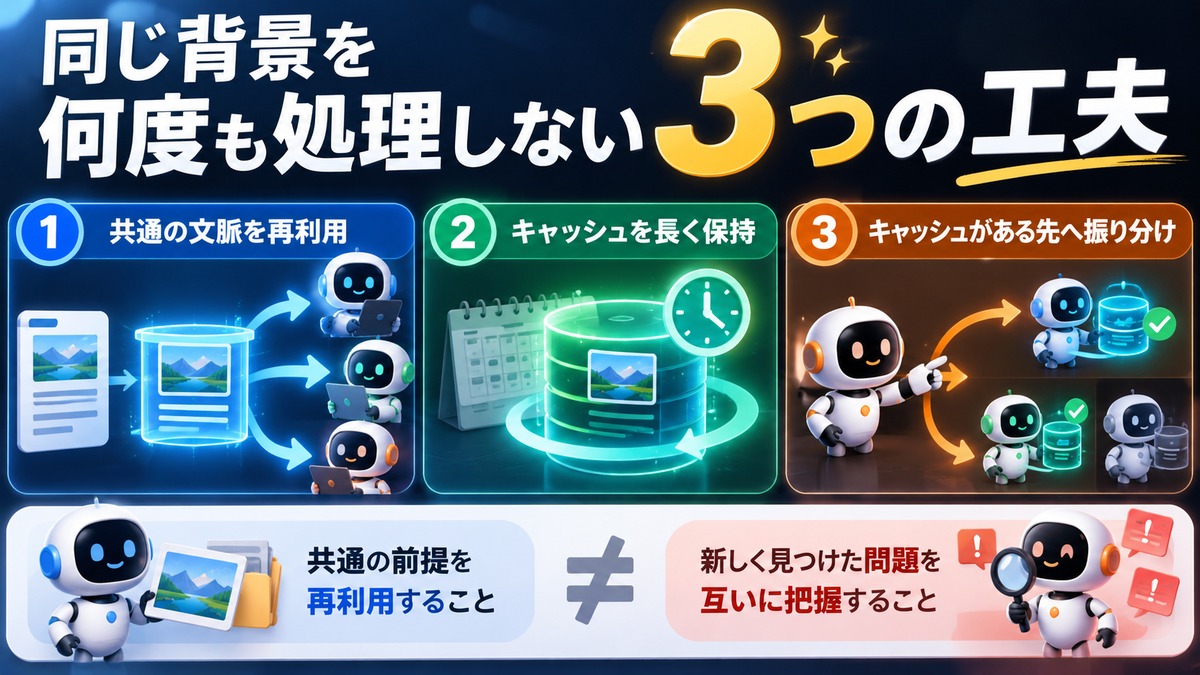
コンテキストとは、AIがその仕事を進めるために参照する指示、資料、会話の履歴などの背景情報です。サブエージェントは、その仕事の一部を分担する補助役のAI。担当が増えるほど、共通の前提をそれぞれが扱う機会も増えます。
DAY12は、その共通部分の扱いを効率化する更新です。以下の例は仕組みを理解するためのもので、筆者の実測結果ではありません。
サブエージェント間で、共通の文脈を再利用する
たとえば、Webサイトを点検するとします。「文章を確認する担当」「リンクを確認する担当」「スマホ表示を確認する担当」に分けても、サイトの目的や変更してはいけない条件は共通です。
毎回その共通部分を一から処理するのではなく、再利用できれば、担当を増やす際の重複を減らせます。今回の発表では、このサブエージェントをまたぐ文脈の再利用が挙げられています。1
ただし、共通の前提を再利用することと、それぞれの担当が新しく見つけた問題を互いに把握することは別です。最後に結果を集めて、「文章の修正でリンク先の説明と矛盾していないか」と照合する工程は、引き続き必要になります。
キャッシュを長く保持し、次の処理でも使いやすくする
キャッシュは、繰り返し必要になる処理結果を一時的に保持して再利用する仕組みです。OpenAIのプロンプトキャッシュでは、入力の共通する先頭部分に対する処理を再利用し、入力を扱う時間やコストを抑えます。4
同じ仕様書をもとに、実装、確認、修正と往復する仕事なら、そのたびに共通の背景が登場します。OpenAIの解説でも、長いツール定義、コードベース、多段階の会話は、繰り返し入力の代表例として挙げられています。5
DAY12の「長く保持する」という変更は、こうした再利用の機会を増やす方向です。ただし、個人の好みを覚えるメモリや、会話を永久保存する機能の話ではありません。また、キャッシュを使うことは、古い回答をそのまま返すことでもありません。公式API文書では、最終的な出力はその都度、新しく計算すると説明されています。14
キャッシュを持っている処理先へ、うまく振り分ける
保存してあるものも、次の処理で見つからなければ役に立ちません。そこで重要になるのが、リクエストをどこへ送るかという振り分けです。
OpenAIのAPI文書では、入力の先頭部分などを使ってリクエストを振り分け、同じ入力のキャッシュを利用しやすくする仕組みが説明されています。DAY12でも、振り分けの改善によってキャッシュヒット、つまり使えるキャッシュが見つかる機会を増やしたとされています。41
ここでいう振り分けは、投稿上はキャッシュを有効に使うためのものです。「安いモデルへ自動で切り替えることで節約した」という発表ではありません。また、APIの説明は背景理解のための参照であり、CodexやWorkの内部実装の全詳細が公開されたわけでもありません。
効きやすそうなのは、同じ土台で何度も進める仕事
以上から考えると、恩恵を期待しやすいのは、同じ資料や仕様に何度も立ち戻る作業です。たとえば、同じコードを段階的に修正する仕事や、共通の資料を使って調査・比較・報告書作成を進める仕事が考えられます。
一方、毎回ほぼ別の資料を渡す作業や、新しい出力を大量に作る部分では、共通入力の再利用だけで全体の負担がなくなるわけではありません。「キャッシュが効く」と「その作業が無料になる」は別です。APIでも、キャッシュされた入力以外の処理や出力には、それぞれの利用・料金条件が残ります。478
GPT-6 Astra Proも高速化。Chatで複数の作業を並行
DAY12の投稿に続いて、Tibo氏はGPT-6 Proの改善にも言及しています。こちらはCodex/Workの利用効率とは分けて、ChatGPTのChatタブにおけるProユーザー向けの更新として読む必要があります。12
Tibo氏の補足返信・日本語訳
すべてのProユーザー向けに、GPT-6 Proも大幅に改善しました。
出典:図1下部の補足返信。1
OpenAI公式投稿の日本語訳
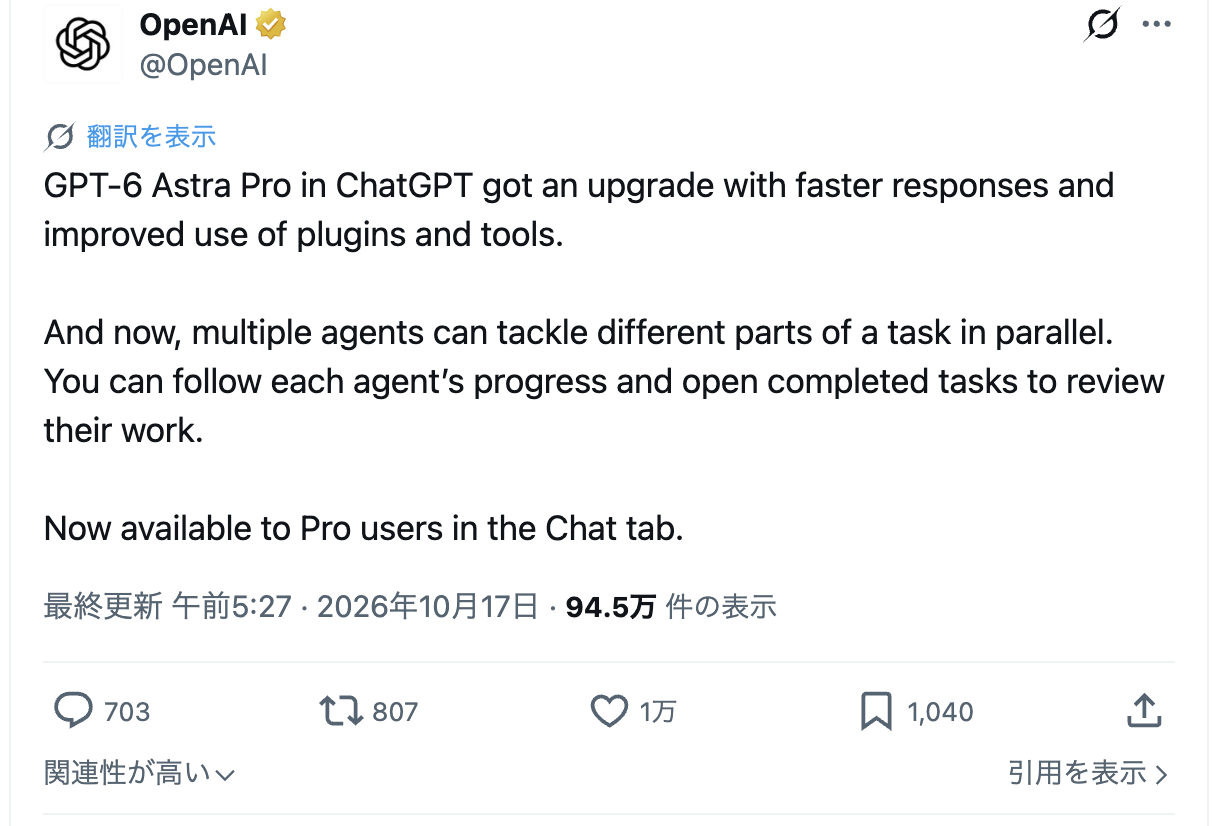
図2:GPT-6 Astra Proの更新を説明するOpenAI公式投稿。対象はChatタブのProユーザーと案内されている。2026年10月17日の投稿画面。2
OpenAI公式投稿・日本語訳
ChatGPTのGPT-6 Astra Proがアップグレードされ、応答が速くなり、プラグインやツールの使い方が改善されました。
また、複数のエージェントが、1つのタスクの異なる部分に並行して取り組めるようになりました。それぞれのエージェントの進捗を追い、完了したタスクを開いて、作業内容を確認できます。
現在、ChatタブでProユーザーに提供しています。
出典:OpenAI(@OpenAI)の投稿。日本語訳は図2の原文に基づく。2
Tibo氏の返信では「GPT-6 Pro」、OpenAI公式の本文では「GPT-6 Astra Pro」と表記されています。本稿では公式投稿に合わせ、以下では後者の名称を使います。
分担するだけでなく、何が終わったかを確認できる
発表で注目したいのは、並列作業そのものに加えて、担当ごとの進捗と、完了した作業を確認できることです。2
筆者がWeb版ChatGPTのChatで「Pro」を選んで作業した画面でも、「サブエージェント 3個を使用」という表示を確認できました。右側には担当ごとの「進行中」「保留中」、会話側には作業開始・更新や「0/3件のタスクが完了しました」という表示があり、複数の担当へ作業が分かれ、進捗が更新される様子が見えます。
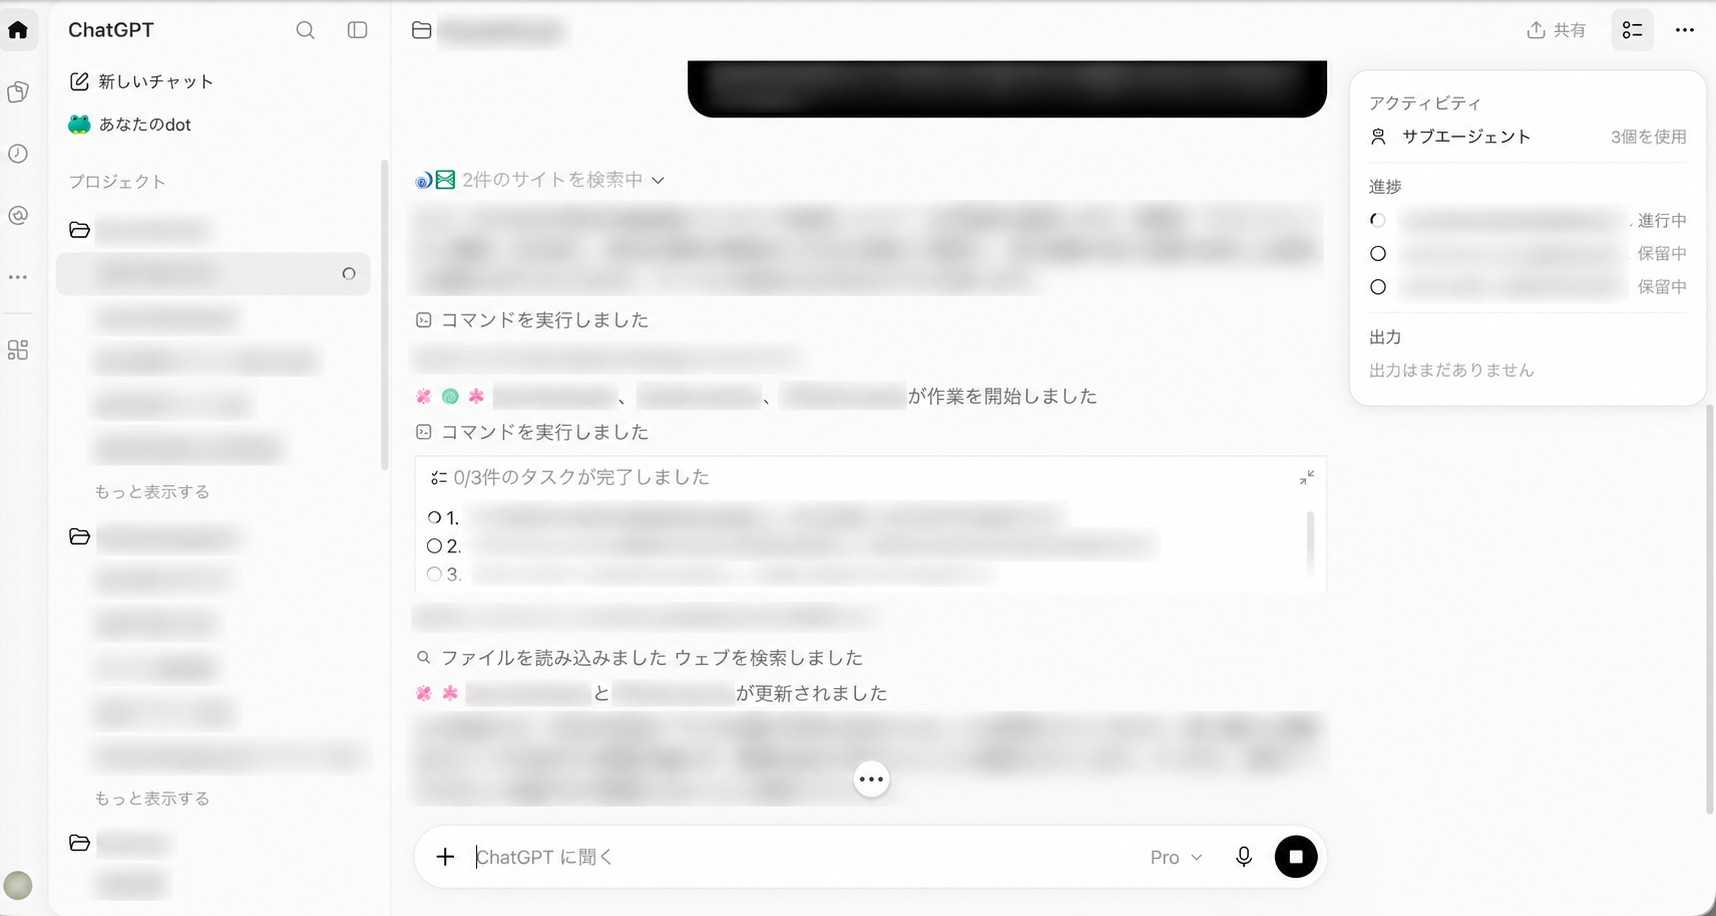
図4:筆者のWeb版ChatGPTでProを使用中の画面。プロジェクト名や作業内容は伏せ、サブエージェント数と進捗表示を残している。
公式ヘルプによると、ChatのGPT-6 ProはGPT-6 Astraを基盤としています。画面の「Pro」と、発表にある「GPT-6 Astra Pro」の関係は、この公式説明で確認できます。11
たとえば、複数のAIサービスを比較するなら、サービスごとに公式情報を調べてもらい、最後に同じ項目で整理する使い方が考えられます。「対象プラン」「料金の条件」「できないこと」を共通の確認項目にしておけば、ある担当だけが宣伝文句を集め、別の担当だけが細かな制限を調べる、といった比較の偏りも点検しやすくなります。
次のように頼むと、分担の目的を具体化できます。これは対応する環境での依頼例であり、今回実行した結果ではありません。
比較するサービスごとに調査を分担し、対象期間と確認項目をそろえてください。各担当は公式情報と未確認点をまとめ、最後に同じ基準で比較してください。担当同士で結論が食い違う部分は、根拠を確認してから統合してください。
もちろん「完了」と表示されたことと、内容が正しいことは同じではありません。担当別の結果を開けるなら、結論の根拠や抜けを確認するところまで活用したい機能です。
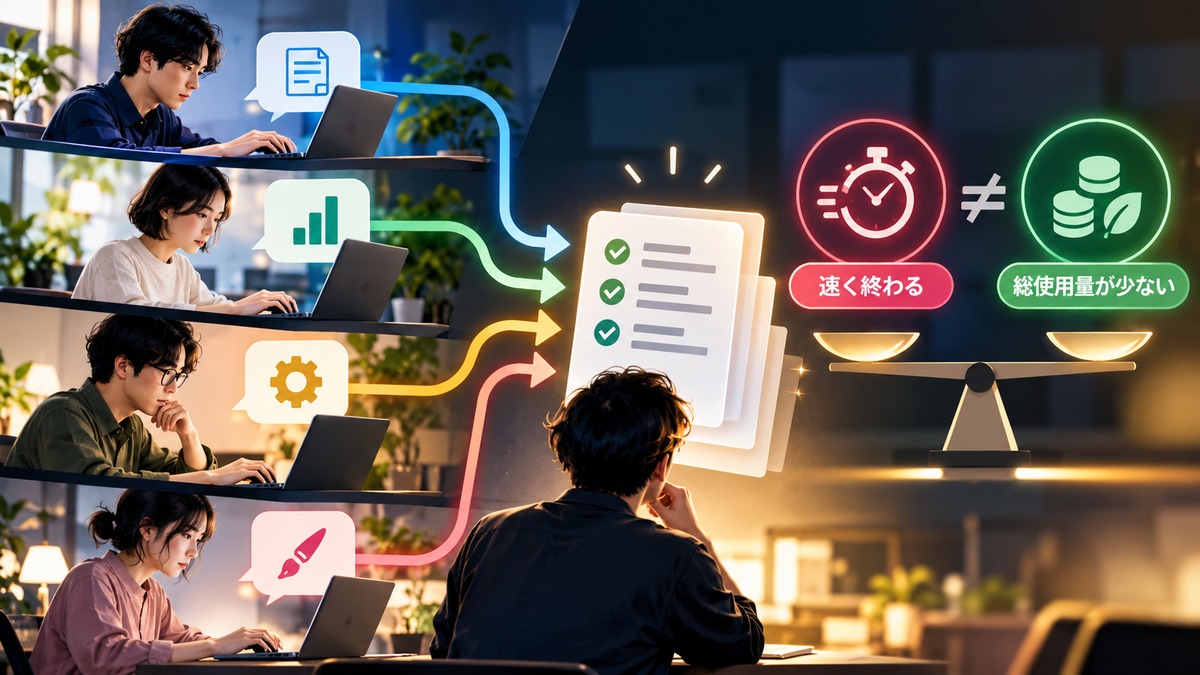
並列化は「待ち時間」と「使用量」を別々に考える
3つの調査を同時に進めれば、順番に待つより早く終わる可能性があります。しかし、3つの担当が動くぶん、全体としては多くの処理を行うこともあります。早く終わることと、総使用量が少なくなることは別の軸です。
たとえば、別々のサービスの調査は分担しやすくても、「仕様を決めてから、その仕様に沿って実装する」という仕事は、前の結論を待つ必要があります。分担を増やす前に、独立して進められる部分かどうかを見極めるほうが大切です。
この観点で見ると、並列作業の拡充と、共通の文脈を効率よく再利用するDAY12の改善は、方向性としてかみ合っています。ただし、Chat側の並列機能とCodex/Work側のキャッシュ改善が、同一の実装だと発表されたわけではありません。
Claude・Geminiも進める「分担」と「再利用」
今回の更新を少し広く見ると、AIを賢くするだけでなく、複数の処理をどう組み合わせ、重複をどう減らすかが重要になっていることが分かります。他社の技術公開にも、この2つの軸が表れています。
Claudeの開発事例では、分担の効果と負担を両方説明
Anthropicは2025年6月の開発記事で、調査を統括するエージェントが複数の担当を動かし、結果を集約する仕組みを紹介しています。独立した方向へ広く調べる仕事に向く一方、担当同士の依存が強い仕事や、多くの共通情報を逐次やり取りする仕事では難しさがあると説明しています。6
同記事では、複数エージェントによる処理はトークン消費も増えやすいとされています。2025年の個別システムの事例なので、現在のChatGPTとの性能比較には使えませんが、「担当を増やせば、そのまま安く速くなるわけではない」という設計上の論点は共通しています。6
キャッシュは、各社のAPIにもある基本技術
ClaudeのAPIには、繰り返す入力をキャッシュする仕組みがあります。GoogleのGemini APIにも自動的に働くキャッシュや、対応モデルで明示的に再利用する仕組みが用意されています。方式、対応モデル、保持期間、料金条件は同じではありません。78
ここで比較したいのは、割引率の大小ではなく、同じ前提を何度も処理する無駄を減らす、という共通の考え方です。各社のAPI料金と、ChatGPTやCodexの月額プランで使える量を、そのまま横並びにすることはできません。
DAY12のニュース価値は、キャッシュという技術を初めて発明したことではなく、その改善をCodex/Workで実質的に使える量の増加につなげたと案内している点にあります。1
関連更新:ChatGPT Spaceにスライド対応
同時期には、Tibo氏がChatGPT Spaceの紹介とスライド対応についても投稿しています。Spaceは、ページやスライド、ファイルなどの成果物をまとめ、人とAIで作業を進める場所です。こちらは利用量の改善とは別に、作ったものを編集・共有する側の更新です。310
Space紹介と追加返信の日本語訳
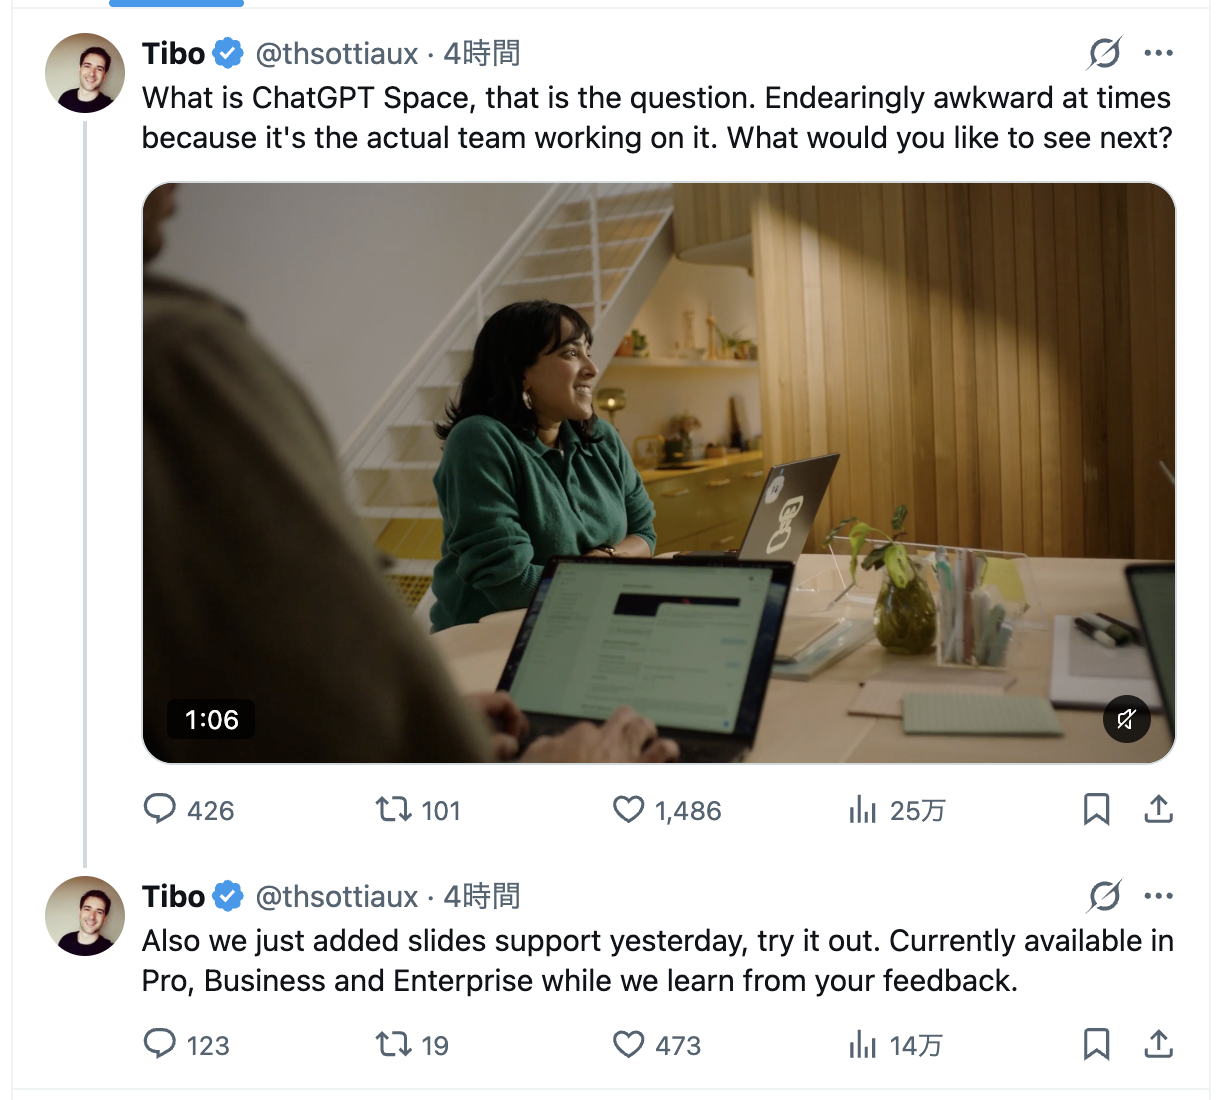
図3:ChatGPT Spaceの紹介投稿と、スライド対応についての追加返信。2026年10月17日の投稿画面。画像は紹介動画の静止画を含む。3
Space紹介投稿・日本語訳
ChatGPT Spaceとは何か、という話です。実際の開発チームが紹介しているので、ときどき少しぎこちないところもありますが、それもご愛敬。次は何を見てみたいですか?
スライド対応の追加返信・日本語訳
それから、昨日スライド対応も追加しました。ぜひ試してみてください。現在はPro、Business、Enterpriseで提供しており、皆さんのフィードバックから学んでいるところです。
出典:Tibo(@thsottiaux)の投稿と返信。日本語訳は図3の原文に基づく。「昨日」は投稿者の表現をそのまま訳しており、日本時間の実装日を特定したものではありません。3
注目点は、完成ファイルを受け取ったあとの修正
公式ガイドでは、会話やアウトライン、資料からSpace上のプレゼンテーションを作り、文字や画像などの要素を直接編集したり、ChatGPTへ修正を頼んだりする流れが案内されています。9
さらに、編集権限を持つ人同士で同じスライドを修正し、共有コメントでやり取りできます。単に「スライドのファイルが1つできる」というだけでなく、同じ成果物を見ながら仕上げるところに意味があります。10
たとえば、AIに説明資料の初稿を作ってもらったあと、人が数字の出典を確認し、担当者が図を直し、最後に説明の順序を整える。そうした後工程まで同じ作業場所で続けられるなら、修正版を何度も別ファイルで受け渡す手間を減らせそうです。
ただし、DAY12の効率化、ChatのPro向け並列作業、Spaceのスライドは、対象も役割も異なります。今回のスライド対応は、投稿時点ではPro・Business・Enterprise向けという案内です。共有する際は、閲覧だけを許すのか、一緒に編集できるようにするのかも確認しましょう。310
ここまでの改善は、それぞれ別の負担を減らしている
連載を追っていると、利用枠、コンテキスト、ディスク容量、混雑対策と、似たような「容量」の話が続きます。しかし、実際に改善している場所は異なります。直近の変化を、何を減らしたり広げたりしたのかで整理すると、DAY12の位置づけもはっきりします。
| 連載の日 | 主な変更・対応 | 見ているもの |
|---|---|---|
| DAY6・8・10 | 使用量のリセットを案内 | 消費した利用枠の回復 |
| DAY7 | Codex/Workで使うGPT-6.1 Solの標準コンテキスト長を272kから500kへ | 1つの作業で扱える文脈の広さ |
| DAY9 | デスクトップアプリの状態データ保存を最適化。保存量60%削減を見込むと発表 | PCのディスク上に置くデータ量 |
| DAY11 | モデルの混雑エラー軽減と、発生時の自動続行を改善 | 作業が中断されにくいこと |
| DAY12 | 文脈の再利用、キャッシュ保持、振り分けを改善 | 同じ利用枠を有効に使うこと |
DAY6〜11はDAY6・7の記事、DAY8・9の記事、DAY10・11の記事で扱った発表の要点。DAY12は図1の投稿。数値は各日の発表内容で、全環境の現在値や筆者の測定値を示すものではない。1
DAY7の文脈拡張とDAY12のキャッシュ改善も、同じではありません。前者は、長い仕事で扱える情報の範囲。後者は、同じ情報を繰り返し扱うときの効率です。DAY9でPC内の保存量が減ることとも区別できます。
こうして見ると、直近の改善は「もっと賢い答えを出す」だけではなく、長い仕事を止めず、無駄を抑え、最後まで続けるための環境整備としてつながっている、と捉えられます。
まとめ:利用回数だけでなく、仕上げられた仕事で見る
DAY12の中心は、共通の背景情報をうまく再利用し、CodexとWorkで実質的に進められる作業を増やすことです。同時期のGPT-6 Astra Proでは分担する力と進捗確認、Spaceでは成果物を共同で仕上げる機能も強化されています。123
この変化を使い方に生かすなら、まずは依頼の目的と共通資料をそろえ、独立して進められる部分だけを分担し、最後に結果を照合すること。キャッシュのために会話を無理に長くしたり、必要のない担当を増やしたりするより、重複ややり直しを減らす仕事の渡し方を考えたいところです。
効果を見るときも、単に「残量が減らなかった」だけで判断しないほうがよいでしょう。同程度の資料量・モデル・推論設定で、利用枠の減り方、修正を含む所要時間、完成物の品質を合わせて見ると比較しやすくなります。途中でリセットや設定変更があった場合は、その影響も分ける必要があります。
リセットで作業を再開できることも大切ですが、普段の仕事で余計な処理を減らせるなら、その価値は日々積み重なります。今回注目したいのは、「何回質問できたか」から、「同じ枠で、どれだけ仕事を仕上げられたか」へという変化です。
参考資料・出典
情報確認日:2026年10月17日。投稿の日本語訳は、本稿に掲載したスクリーンショットの原文に基づきます。Xのリンクは投稿者のプロフィールです。
[1] Tibo(@thsottiaux)「Day 12」とGPT-6 Proに関する補足返信
2026年10月17日の投稿画面(図1)。実効利用量の改善と3つの方法は、この画面を根拠としています。投稿者のプロフィール
[2] OpenAI(@OpenAI)GPT-6 Astra Proの更新告知
2026年10月17日の投稿画面(図2)。高速化、プラグイン・ツール利用の改善、並列作業、進捗・完了結果の確認、ChatタブのProユーザー向けという案内を確認。画面の5:27は最終更新の表示です。OpenAI公式プロフィール
[3] Tibo(@thsottiaux)ChatGPT Space紹介とスライド対応の追加返信
2026年10月17日の投稿画面(図3)。スライド追加とPro・Business・Enterprise向けの案内を確認。投稿者のプロフィール
[4] OpenAI「Prompt caching」
入力の共通部分の再利用、キャッシュヒット、リクエストの振り分け、出力は新しく計算されることなどの背景説明に参照。API仕様をDAY12の製品別利用枠へ直接当てはめたものではありません。公式APIガイド
[5] OpenAI Cookbook「Prompt Caching 101」
2024年10月1日公開のアーカイブ。ツール定義、コード、長い会話など、同じ入力を繰り返し使う基本例に参照。掲載当時のモデル・割引率・閾値を現行仕様として引用していません。解説記事
[6] Anthropic「How we built our multi-agent research system」
2025年6月13日公開。調査の分担、統括役への集約、並列化に向く仕事とトークン消費のトレードオフを理解するための開発事例。開発解説
[7] Anthropic「Prompt caching」
Claude APIの繰り返し入力のキャッシュと、利用・料金条件の区別を参照。公式APIガイド
[8] Google「Context caching」
Gemini Generate Content APIのキャッシュ解説。自動型と対応モデルでの明示型、キャッシュ以外の入出力や保存期間に関する条件を参照。Geminiの全モデルで同一方式が使えるという意味ではありません。公式APIガイド
[9] OpenAI「Get started with ChatGPT Space」
会話・構成案・資料からスライドを作り、直接編集またはChatGPTへの依頼で修正する流れを参照。公式ガイド
[10] OpenAI「Manage ChatGPT Space, pages, and slides」
Spaceの位置づけ、スライドの共同編集、閲覧・編集権限、共有コメントに参照。公式ガイド
[11] OpenAI Help Center:Managing usage with GPT-6 Astra in Work and Codex(2026年10月17日確認)。ChatのGPT-6 ProがAstraを基盤とすることを確認。
コメント