Claudeを開くたびに、「とりあえず高性能なOpusを選んでおこう」と考えていませんか。難しい相談には心強い選択ですが、メールの下書きや資料の要約まで、毎回同じモデル・同じ思考量にする必要があるでしょうか。
2026年9月28日、AnthropicはClaude Sonnet 5.5を公開しました。9月22日に登場したOpus 5.5に続く、Claude 5.5シリーズの新モデルです。1
普段使いで選ぶなら、まず注目したいのは「どちらが上か」よりも、作業の範囲が決まっているか、途中で難しい判断が必要になるかという違いです。この記事では、Sonnet 5.5の進化、Opus 5.5との使い分け、料金と利用条件を整理します。あわせて、思考量を最大にしても結果がよくなるとは限らない、公式評価の具体例も見ていきます。
Sonnet 5.5で変わったこと|速さと作業効率に注目
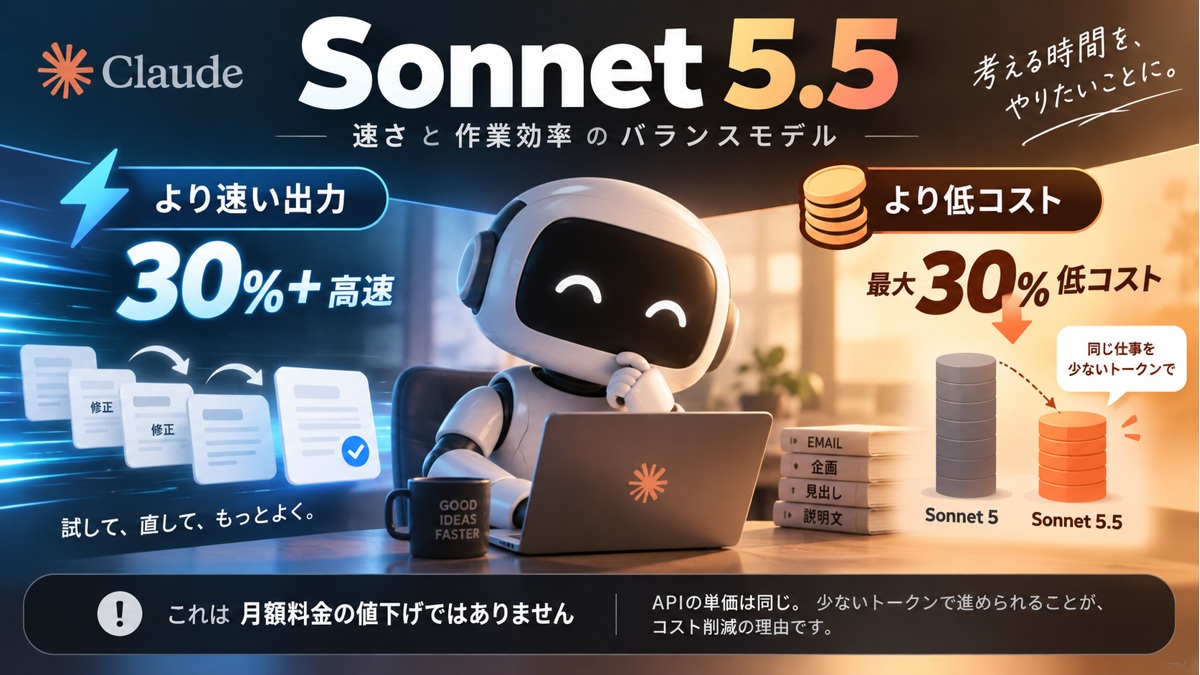
Sonnet 5.5は、速さと知的な作業能力のバランスを重視するモデルです。公式のモデル一覧でも、長時間の自律的な開発や知識業務を担うOpus 5.5と、速度・能力の組み合わせを重視するSonnet 5.5は、異なる役割として紹介されています。7
出力が速くなると、修正を繰り返す作業に使いやすい
Anthropicは、Sonnet 5.5について、前モデルのSonnet 5より出力生成が30%以上速いと説明しています。2
例えば、メールを短くする、見出しを考え直す、説明の言い回しを変えるといった作業では、1回の回答だけで完成するとは限りません。少し直して、読み直し、もう少し調整する。その往復を前提にすると、応答の速さはモデルを選ぶ大切な条件になります。
ただし、「出力が30%以上速い」は、あらゆる仕事の完了時間が30%短くなるという意味ではありません。回答前の思考や、検索・ファイル処理などにかかる時間も含めて、自分の作業ではどう変わるかを見る必要があります。
「最大30%低コスト」は、月額料金の値下げではない
もう1つの特徴は、Sonnet 5と比べて、一般的なトークン課金の作業で実行コストが最大約30%下がるというAnthropicの説明です。2
ここは誤解しやすいところですが、ProやMaxの月額料金が30%安くなった、という発表ではありません。 APIの通常の入力・出力単価はSonnet 5と同じで、同じ仕事を少ないトークンで進められることが、費用削減の理由として説明されています。トークンとは、AIが文章などを処理するときの単位です。345
この違いを踏まえると、見るべきなのは単価だけではありません。途中で何度もやり直すのか、短いやり取りで必要な成果物まで届くのか。実際の使いやすさは、そこまで含めて判断したいところです。
Opus 5.5との違い|実務評価が近くても、得意な仕事は同じではない
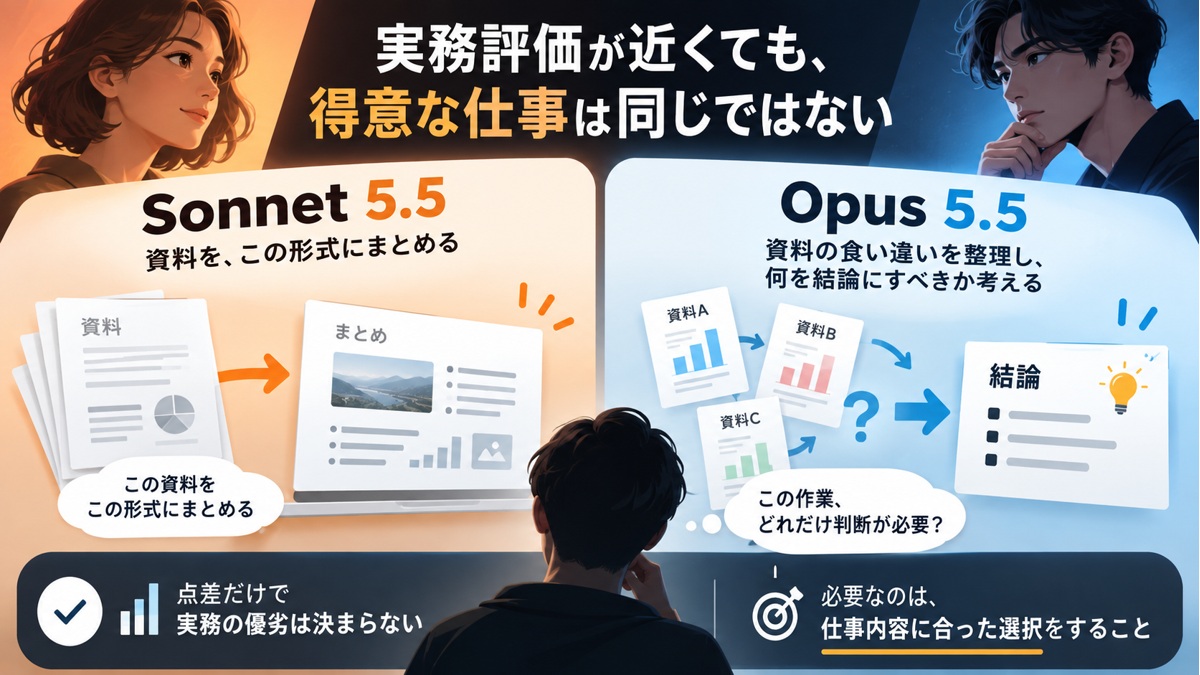
Sonnet 5.5とOpus 5.5を比べるときは、性能評価の点数と、実際に任せる仕事を分けて考えると分かりやすくなります。特定の評価で近い点数になったからといって、すべての用途で置き換えられると決まるわけではありません。
文書やスライドなどの成果物を比べる評価では、両者は近い
実務に近い評価の1つに「GDPval-AA」があります。44の職種、9つの主要産業に関わる仕事を題材に、文書・スライド・表計算などの成果物を作らせ、その品質を比較する評価です。単純な一問一答の正答率ではなく、成果物の比較から相対的な評点を付けています。8
2026年10月2日に確認した評価サイトの掲載値は、次のとおりです。
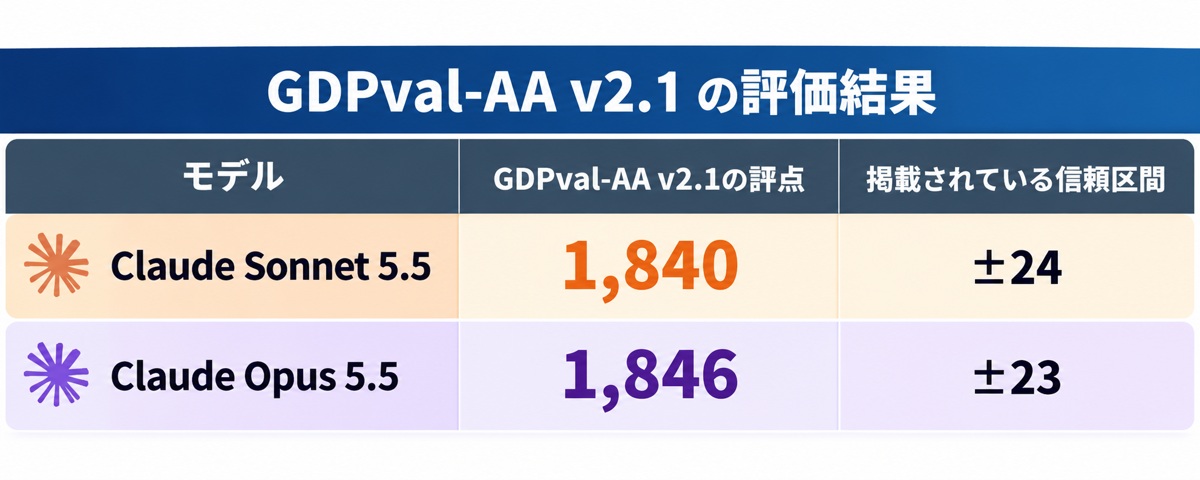
出典:Artificial Analysis。両者ともAdaptive Reasoning・Max effort・Default Fallbackでの結果です。信頼区間は評価値の不確かさを示します。この点差だけで、実務全般の明確な優劣が証明されたとはいえません。8
なお、Anthropicの9月28日の発表資料では、Sonnet 5.5は1,844と掲載されています。上の表はそれとは区別して、10月2日に確認できた評価サイトの値を使っています。38
大切なのは、これは両モデルとも思考量を最大にした条件での比較だということです。普段のアプリの初期設定で、同じ評価結果がそのまま得られることを意味するものではありません。
Opusを選びたいのは、判断の難しさが積み重なる仕事
Opus 5.5は、大きなコードベースの開発、複数のツールを使う長時間の作業、複雑な文書作成などを重視したモデルです。公式のAPI向けモデル一覧でも、多くの仕事の出発点としてOpus 5.5が案内されています。67
日常の仕事に置き換えると、違いは次のように考えられます。
「この資料を、この形式にまとめる」ならSonnetを試しやすい。一方、「資料同士の食い違いを整理し、何を結論にすべきか考える」ならOpusを検討したい。
文章が長いか短いかだけではなく、作業の途中でどれだけ判断が必要になるかを見るわけです。例えば、長い説明書から決まった項目を抜き出す作業と、短い情報しかない状態で原因不明の不具合を調べる作業では、後者のほうが難しい判断を求めることもあります。
参考までに、APIの仕様では、両者とも100万トークンのコンテキストと最大128,000トークンの出力に対応しています。コンテキストは、1回の処理で参照できる情報量の上限です。これはAPIの仕様であり、Webアプリのファイル容量や利用上限と同じものではありません。4
普段使いで選ぶ基準|メール・記事・資料づくりならどう使う?
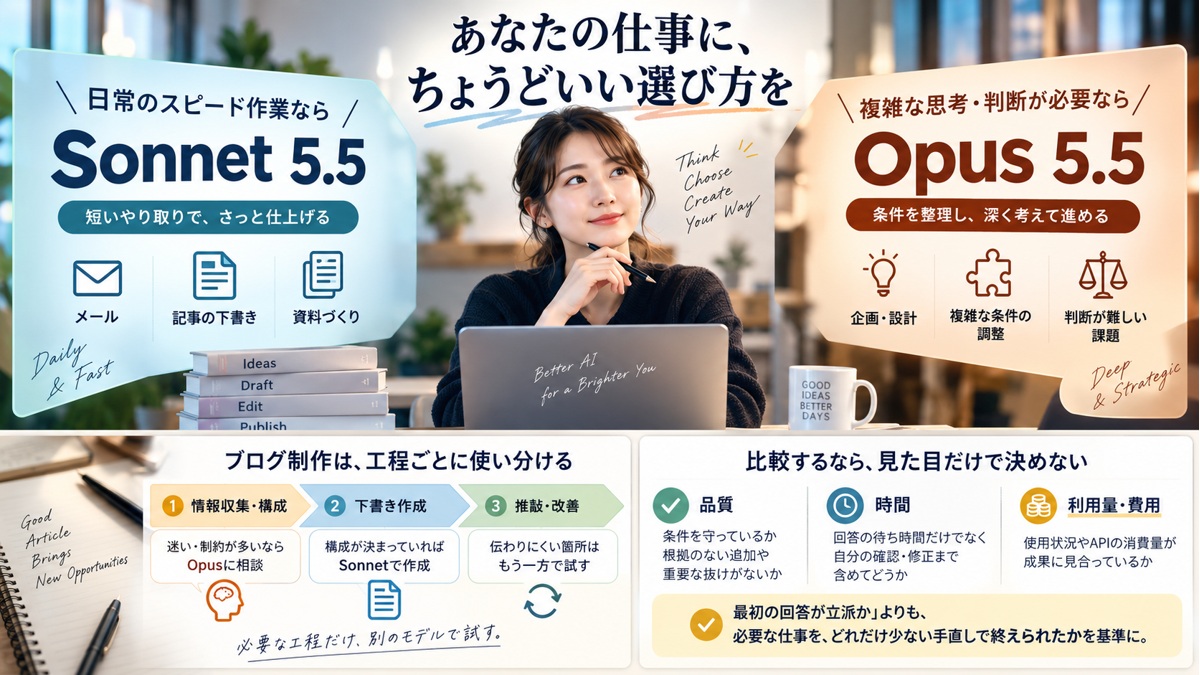
ここからは、公式のモデルの位置づけを、身近な作業に当てはめてみます。短いやり取りで仕上げる日常作業はSonnet 5.5から、条件の整理や複雑な判断が中心の仕事はOpus 5.5から。これを最初の選び方にすると、単に高いモデルへ固定するより、自分の作業との相性を確かめやすくなります。
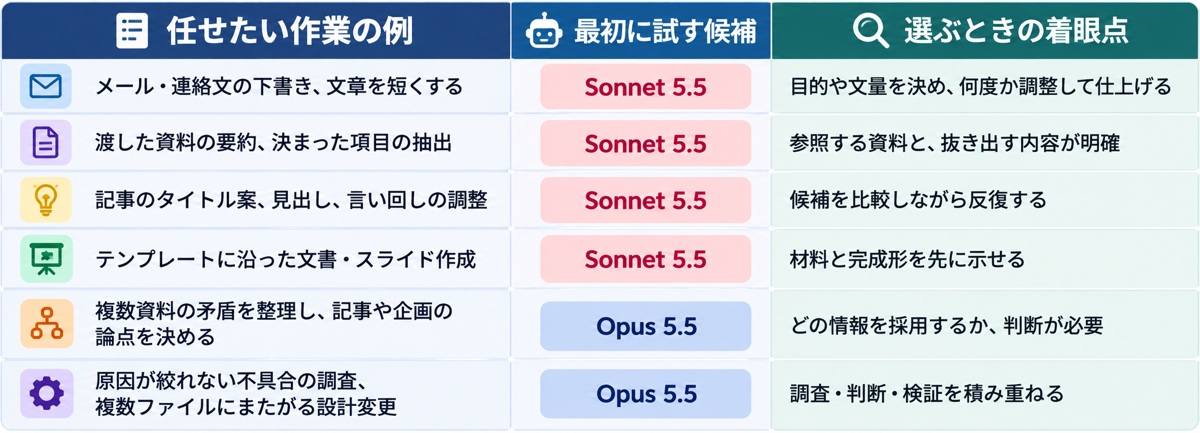
この表は、各作業の優劣を実測したランキングではなく、試し始めるための目安です。特に日常作業を対象にした使い分けであり、あらゆる用途でSonnetを先に使うという意味ではありません。
ブログ制作なら、工程ごとに使い分ける
記事を作る場合も、「記事執筆はすべてOpus」「下書きはすべてSonnet」と固定する必要はありません。
例えば、参考資料と構成が決まっていれば、Sonnetで下書きを作り、読者に伝わりにくい箇所を直していく方法が考えられます。反対に、情報が食い違っている、何を主題にするか決まらない、複数の制約を両立させる必要があるときは、最初の設計をOpusに相談する選び方です。
毎回2つのモデルに全文を書かせるより、うまく進まない工程だけ、別のモデルで試すほうが、比較する範囲も明確になります。
比較するなら、回答の見栄えだけで決めない
自分に合うか確かめるなら、普段よく頼む作業を、同じ資料・同じ指示で試すのが分かりやすい方法です。見たいのは、次の3点です。
- 品質: 指定した条件を守り、根拠のない追加や重要な抜けがないか。
- 完成までの時間: 回答を待つ時間だけでなく、自分の確認・修正まで含めてどうか。
- 利用量・費用: アプリの使用状況やAPIの実際の消費量が、成果に見合っているか。
整った文章が返ってきたことと、そのまま使えることは別です。「最初の回答が立派だったか」より、「必要な仕事を、どれだけ少ない手直しで終えられたか」を基準にしてみましょう。
AIは長く考えるほど正確?思考量を最大にする前に知りたいこと
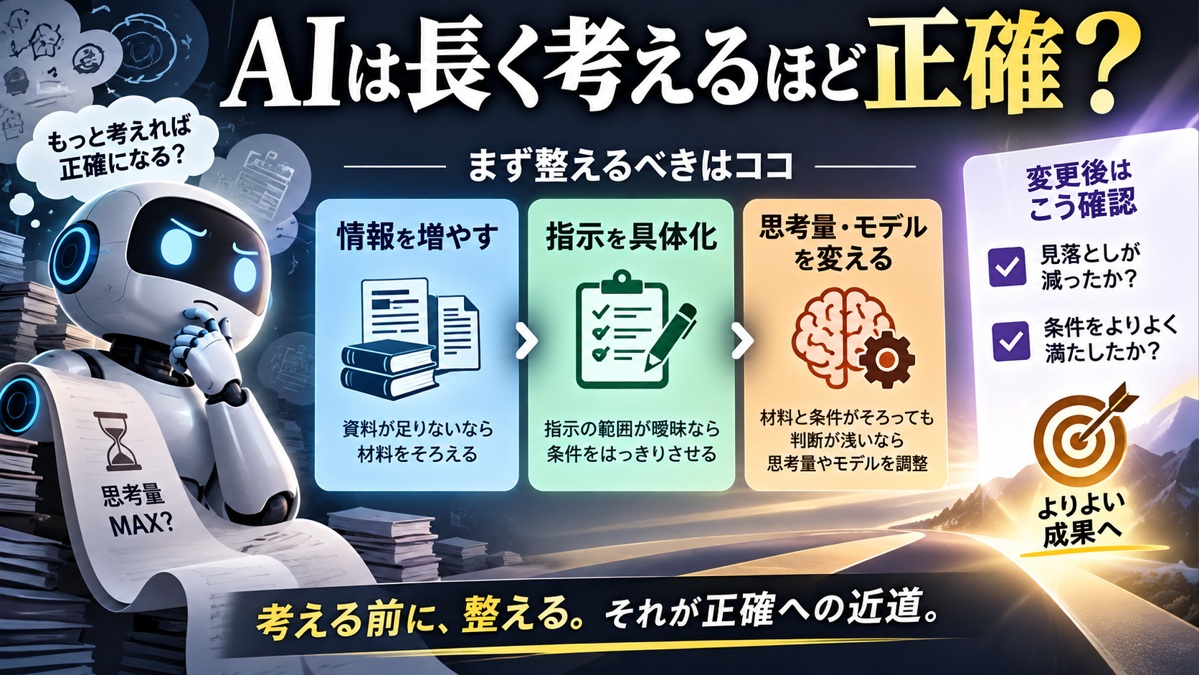
モデルとは別に、結果に影響するのが「effort」という思考量の設定です。これは、回答のためにどれくらい考えるかを調整するもので、高くすると待ち時間やトークン消費も増える傾向があります。ただし、設定を上げれば正確性や仕事の成功率が必ず上がるわけではありません。10
公式評価では、Maxが1段階下のXhighを下回った
Sonnet 5.5の発表資料には、実務での使い方を考えるうえで興味深い結果が載っています。コード修正を評価する「FrontierCode 1.1(Main)」で、思考量を最大にした結果が、1段階下の設定を下回ったのです。3
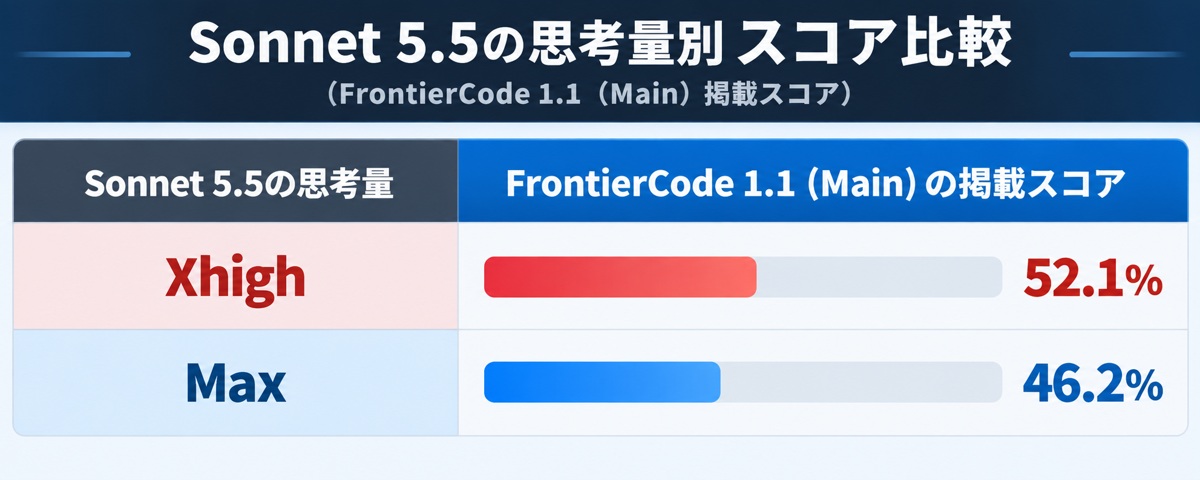
MaxはXhighより5.9ポイント低い結果でした。ただし、これを「長く考えたので、頭が混乱した」と説明するのは不正確です。
Anthropicの脚注によると、Maxでは複数の補助AIに処理を分担させるコードレビューを実行することが増え、評価元のCognitionが確認した2例で、時間切れや依頼範囲を超えた追加修正につながりました。この評価は、人の手直しなしで修正を取り込めるかを見るため、内容がよい変更でも範囲外なら減点されます。3
つまり、問われていたのは、コードを考える力だけではなく、指定された範囲で、仕事を終える力でもあったわけです。2例の分析だけで、スコア差全体の原因が説明し尽くされたと考えることも避けたいところです。
「Maxは使わないほうがよい」とも言い切れない
反対に、Artificial Analysisの複数分野をまとめた総合指標では、Sonnet 5.5のMaxは56、Xhighは52と、Maxのほうが高い掲載値になっています。先ほどとは評価する課題や採点方法が異なるため、点数同士を直接比べることはできませんが、思考量を増やす利点がある場面も分かります。9
大切なのは、「長く考えるほど正確」「短く考えれば安全」という単純なルールにしないことです。難しい条件を整理するために考える時間が必要な仕事もあれば、追加の処理を重ねるより、指定どおりに終えるほうが重要な仕事もあります。
設定を上げる前に、回答が悪い理由を見分ける
期待した答えが返ってこないときは、すぐにMaxへ上げる前に、何が足りないのかを分けてみましょう。
情報が足りないなら、資料を増やす。 Sonnet 5.5とOpus 5.5の知識の基準時点は2026年6月です。最新の料金や新製品について、思考量を増やすだけで新しい事実が補われるわけではありません。必要なのは、公式ページの確認や最新資料の提供です。4
指示の範囲が曖昧なら、条件を具体化する。 「よくして」ではなく、直してよい箇所、変えてはいけない内容、完成とみなす条件を示します。
材料と条件がそろっていても判断が浅いなら、思考量やモデルを変える。 この場合はHighなどへ上げる、Opus 5.5で検討する、といった比較に意味があります。変更後は、文章が長くなったかではなく、見落としが減ったか、条件をよりよく満たしたかで判断します。
思考量はどう設定する?アプリ・Claude Code・APIの違い
同じSonnet 5.5でも、使う場所によって初期設定が異なります。Anthropicが発表したSonnet 5.5の初期設定は、次のとおりです。3
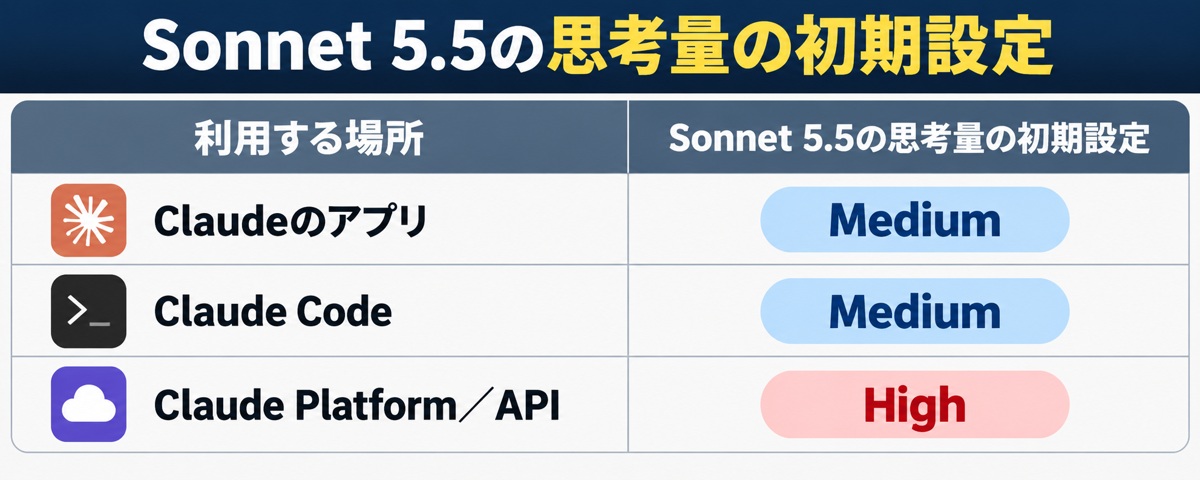
このため、APIでの検証結果を、そのままアプリの普段使いと同じ条件だと思わないことが大切です。API側の公式ガイドでも、対話など応答の速さを重視する仕事ではMediumやLowから、範囲が明確な開発作業ではMediumから試す案内があります。10
普段は初期設定から、必要な理由があるときに調整する
思考量には、Low、Medium、High、Extra high(Xhigh)、Maxという段階があります。Claudeの対象モデルでは、送信ボタン付近のモデル名から「Effort」を開いて調整します。Enterpriseでは管理者がモデルや思考量を制限する場合もあるため、実際に表示される選択肢と「Default」の表示を確認してください。11
日常的な下書きや要約なら、まずMediumで結果を見て、足りないときに上げる方法が考えられます。最高設定を常用する前に、待ち時間や利用量の増加に見合う改善があるかを確認しましょう。
ただし、Lowにすればいつでも効率的というわけでもありません。Sonnet 5.5の公式ガイドは、低い思考量ではコード変更の検証を省いたり、長い作業の途中で確認のために止まったりする場合があると説明しています。一方、高い思考量や自由度の高い依頼では、頼んだ範囲以上の作業を行うことがあります。12
こうした違いを踏まえ、修正を依頼するときには、例えば次のように範囲と終了条件を添えると比較しやすくなります。
修正するのは、今回指定した範囲だけです。対象外の改善案があれば、実行せず提案として分けてください。指定条件を満たしたことを確認し、作業結果と確認できなかった点を報告して終了してください。
これは本記事で作成した指示例で、必ず守られることを保証するものではありません。設定と指示の両方を変える場合も、何を変更したのか記録しておくと、効果を見分けやすくなります。
アプリでは「思考オフ」にできない点にも注意
Claudeのアプリでは、Sonnet 5.5とOpus 5.5の思考をオフにすることはできません。思考量を下げることと、思考機能を完全に止めることは別です。11
APIには別の仕様があります。Sonnet 5.5では、between_toolsという設定で回答前の思考を止め、ツール呼び出しの間に思考させる方法があります。ただし、使えるのはHigh以下の思考量で、XhighやMaxではエラーになります。従来のthinking: {"type": "disabled"}も使えないため、APIや自作ツールから移行する人は公式の移行ガイドを確認してください。アプリの画面に同じ設定項目がある、という説明ではありません。13
また、有料の「Maxプラン」と、思考量の「Max」は別のものです。契約プランは利用できる枠などに関わる仕組みで、思考量は回答ごとの処理の深さを調整する設定です。高いプランに契約していても、毎回最大の思考量にする必要はありません。1511
無料で使える?Pro・MaxとAPI料金を分けて確認
Sonnet 5.5は、高額なMaxプランだけのモデルではありません。公式のSonnet製品ページは、Web・iOS・AndroidのClaudeで誰でも利用できると案内しています。一方、Opus 5.5はPro・Max・Team・Enterprise向けです。26
以下は2026年10月2日に確認した情報です。円換算は金額の目安として、1米ドル=150円と仮定しています。実際の為替レートを示すものではなく、日本向けの円建て価格や請求額とも異なります。税金、契約する地域、Web・アプリストアなどの購入経路によって、最終的な支払額は変わります。1415
個人向けプランでは、Proでも両方を使える
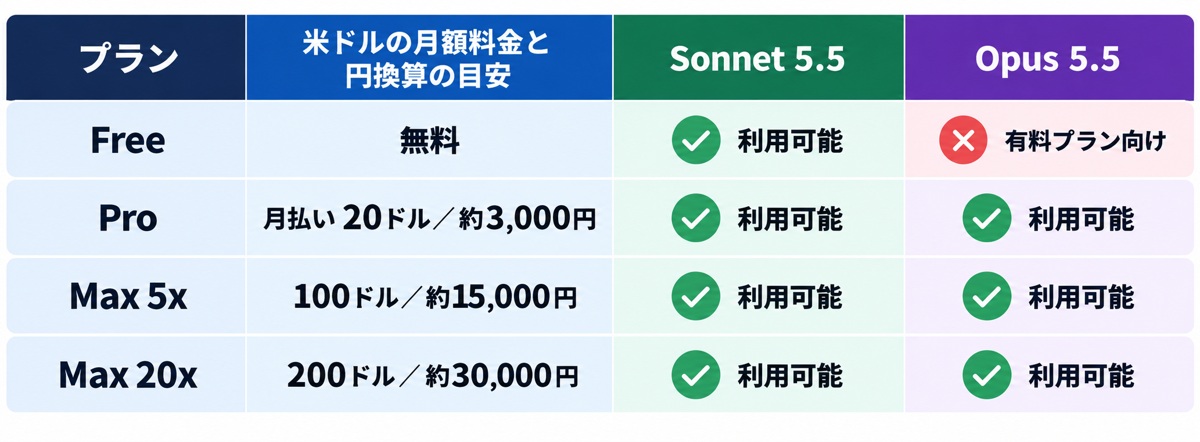
料金は主にWeb契約の米ドル表示を基準にしています。Proの年払いは別条件です。Team・Enterpriseでも両モデルを利用できますが、組織の管理設定も確認してください。14152611
ProとMaxには、5時間単位の利用枠や、全モデルを通じた週単位の上限があります。利用できる量は、文章・添付資料・会話の長さや、使うモデル・機能などによって変わるため、「Sonnetなら何回、Opusなら何回」と一律には決められません。1415
モデルの比較だけが目的なら、Opusを使うために必ず月約30,000円相当のMax 20xへ上げる必要はありません。まず、現在の契約でどのモデルを使えるかと、自分が利用枠にどれくらい達しているかを確認するのが先です。
APIでは、通常の入力・出力単価がOpusの半分
APIは、自作ツールや外部のシステムからモデルを呼び出す使い方で、基本的に処理量に応じて課金されます。Proの契約料金にAPIの利用料が含まれているわけではありません。14
標準のトークン単価は次のとおりです。単位はすべて100万トークンあたりで、100万文字あたりではありません。円換算はここでも1ドル=150円の仮定です。
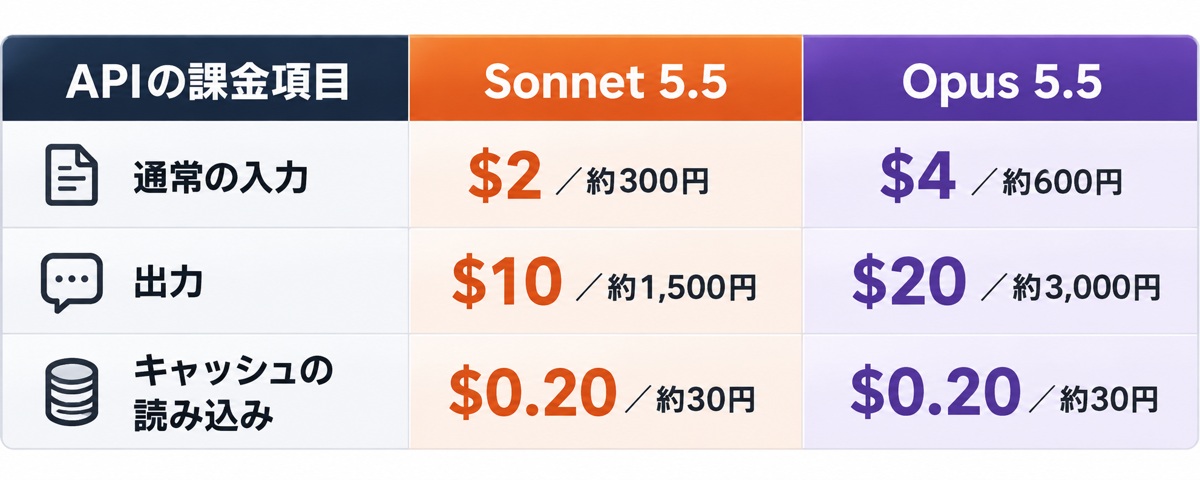
出典:Anthropicのモデル仕様・製品ページ。キャッシュは、条件を満たす過去の入力を再利用する仕組みです。キャッシュの書き込みや高速モードなどは別条件のため、この表には含めていません。46
通常の入力・出力単価はSonnet 5.5が半分ですが、キャッシュ読み込みは同額です。また、作業ごとのトークン量が同じとは限らないため、最終的な費用まで必ず半額になるとはいえません。
アプリの月額プランは「契約内でどれくらい仕事ができるか」、APIは「完成までに何をどれだけ消費したか」。この2つを分けると、料金比較を読み違えにくくなります。
まとめ|モデルの格より、仕事との相性で選ぼう
Sonnet 5.5を試すなら、まずはメールの下書き、資料の要約、記事の見出し調整など、完成形を具体的に示せる仕事から始めると、相性を確かめやすいでしょう。条件の整理や難しい判断が中心になる仕事では、Opus 5.5も比較対象になります。
思考量も、最大に固定するのではなく、結果が足りない理由に合わせて調整するものです。情報不足なら資料を増やし、範囲が曖昧なら指示を絞り、判断の深さが足りないなら設定やモデルを変える。順番を分けることで、何が改善に効いたのかが見えてきます。
選びたいのは、いちばん高いモデルではなく、自分の仕事を、納得できる品質と手間で終えられる組み合わせです。
Opus 5.5の進化や利用枠リセットについては、Claude Opus 5.5の解説記事も参考にしてください。
参考資料・出典
提供条件・仕様・料金・評価値は、2026年10月2日に確認した公開情報に基づきます。発表時の数値と、その後に確認した評価サイトの数値は、本文中で区別しています。
コメント