Codexの28日間の改善企画は、DAY20・DAY21と続けてリセット。そしてDAY22には、GPT-6.1 Terraが登場しました。
気になったのは、発表に添えられたグラフです。Terraの線がSolより上にあり、しかも左にある。「安いのに、Solより性能が高いということ? それならSolを選ぶ意味は?」と、戸惑う見せ方でもあります。
先に答えると、この評価では、TerraがSolより低い費用で高いスコアを出している、という読み方で合っています。ただし、すべての能力でSolを上回ったという意味ではありません。 比較対象はどちらもGPT-6.1なので、「古いSolと比べているだけ」と片づけることもできません。公式のグラフ投稿
一方で、OpenAIは深い調査や複雑なコーディングにはSol/Astraを勧めています。別の独立評価では、SolがTerraを上回る結果もあります。今回は、この一見ちぐはぐな話を、グラフの読み方、料金、仕事での使い分けへつなげて整理します。公式の使い分け・Artificial AnalysisのTerra評価・Sol評価
前回のdots通話・推論設定・CLIの改善を扱ったDAY17〜19の記事に続く記録です。料金と提供条件は、2026年10月27日・日本時間の公式資料で確認しています。
AI生成による、仕事に合わせたモデル選びのイメージ。
DAY20・21はリセット。告知と反映の続報を分けて見る
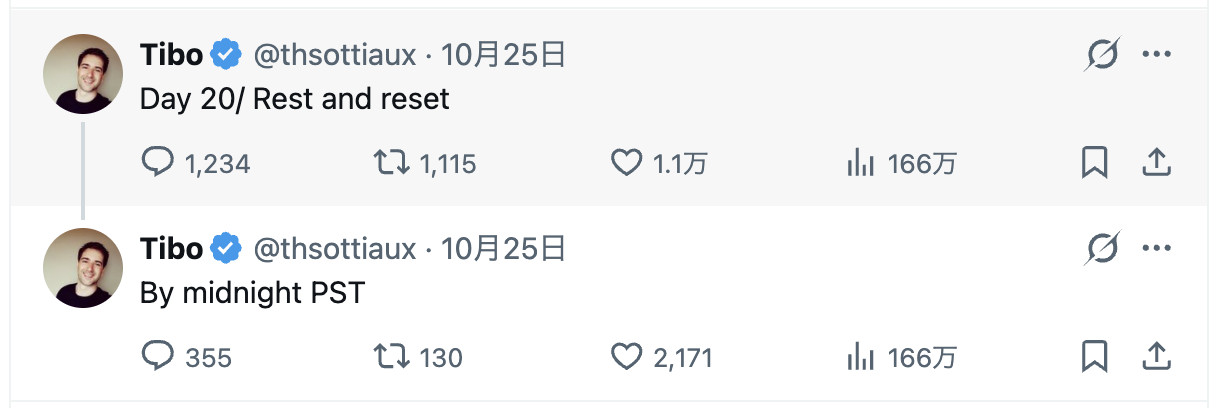
画像内の日本語訳(本投稿・返信の全文)
Tibo氏・本投稿
DAY20/休息とリセット。
Tibo氏・返信
深夜0時までに(原文:PST)。
今回のDAY20・DAY21は、28日間企画としてはどちらもリセットでした。ここでいうリセットはCodexの利用枠を戻すことで、会話や作業ファイルを消す意味ではありません。DAY20には反映完了の続報もあり、告知だけで終わっていない点を押さえておきます。DAY20・完了続報・DAY21
DAY20は「休息とリセット」。その後、反映完了を投稿
DAY20の本投稿は、とても短いものでした。返信では反映の期限も示しています。
その後には、「すべてに反映されました」という続報が出ています。
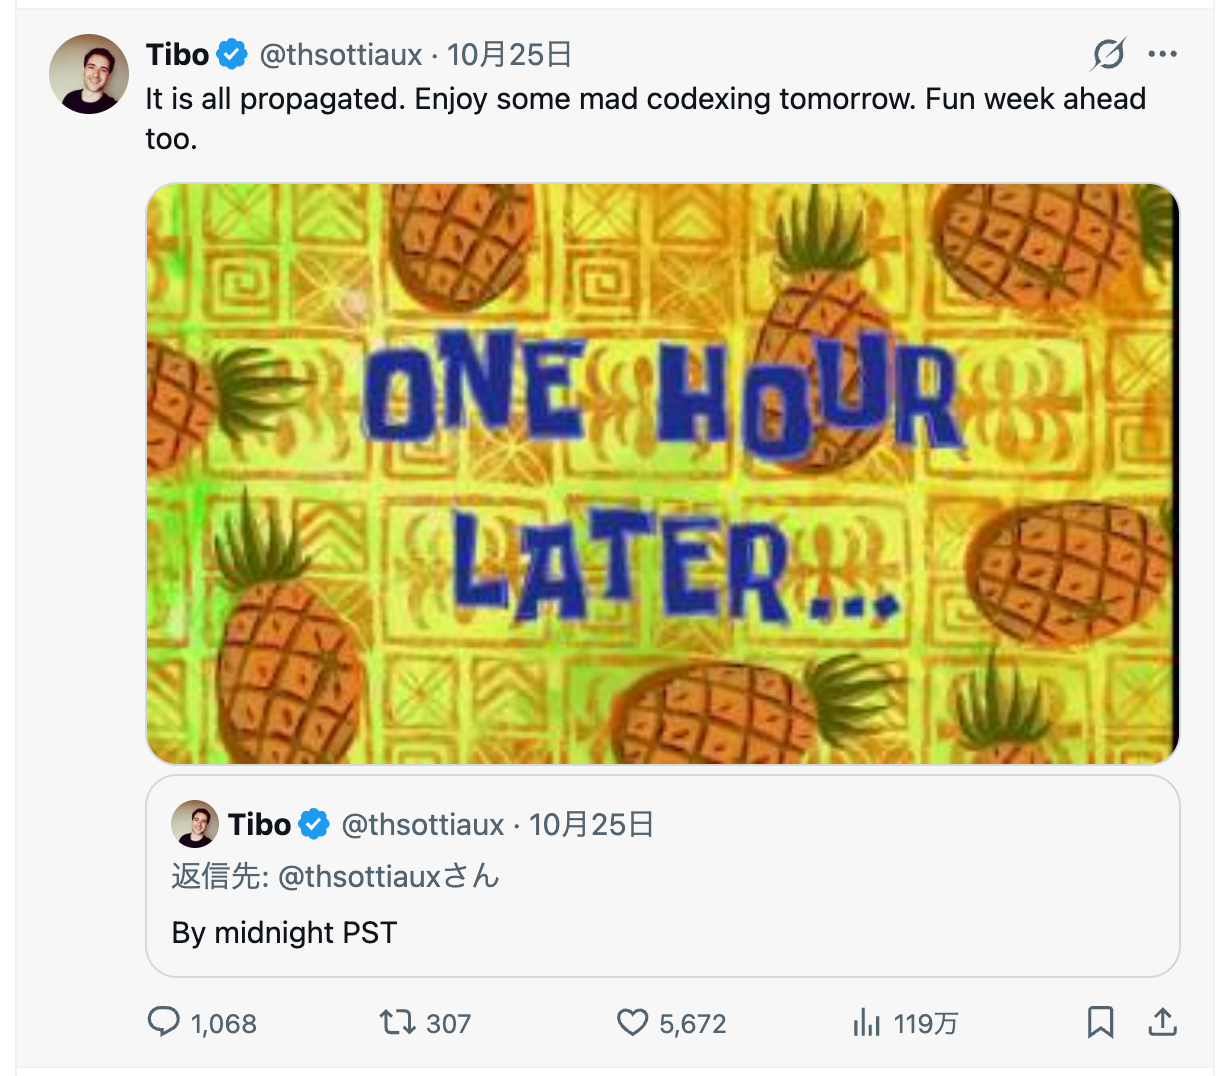
画像内の日本語訳(本投稿・画像内字幕・引用返信の全文)
Tibo氏・本投稿
すべてに反映されました。明日は思いきりCodexを使って楽しんでください。この先の1週間も楽しみです。
画像内の字幕
1時間後……
引用されている返信
深夜0時までに(原文:PST)。
出典:Tibo氏の反映完了の続報。引用されているのはDAY20の期限返信です。
「1時間後……」は投稿に添えられたミームの字幕です。リセット処理に実際に1時間かかったことを示す計測結果ではありません。また、期限に使われているPSTは原文の表記を残しています。日本時間の午前0時を指しているわけではありません。
前回のDAY17・18では、米国太平洋時間で翌朝の反映が予告されましたが、今回のDAY20は「深夜0時まで」という返信と、完了の続報をそれぞれ確認できます。利用枠が戻るタイミングは、日ごとの案内と自分の残量表示を合わせて見るのが確実です。前回の記事
DAY21もリセット。残り7日への期待をにじませる
DAY21の投稿では、残りの日程に触れつつ、その日はリセットとしています。
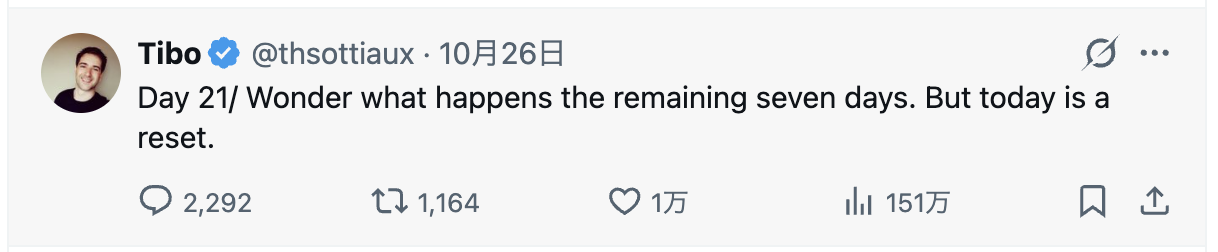
画像内の日本語訳(全文)
DAY21/残りの7日で何が起こるのでしょうね。でも、今日はリセットです。
出典:Tibo氏のDAY21の投稿。「残り7日」は、この投稿時点の表現です。
DAY21について、今回確認できたのはリセットの告知です。「すべてに反映されました」という先ほどの投稿はDAY20の続報で、DAY21の完了を示すものではありません。
DAY22はGPT-6.1 Terra。「画面を理解し、仕事を進める」モデル
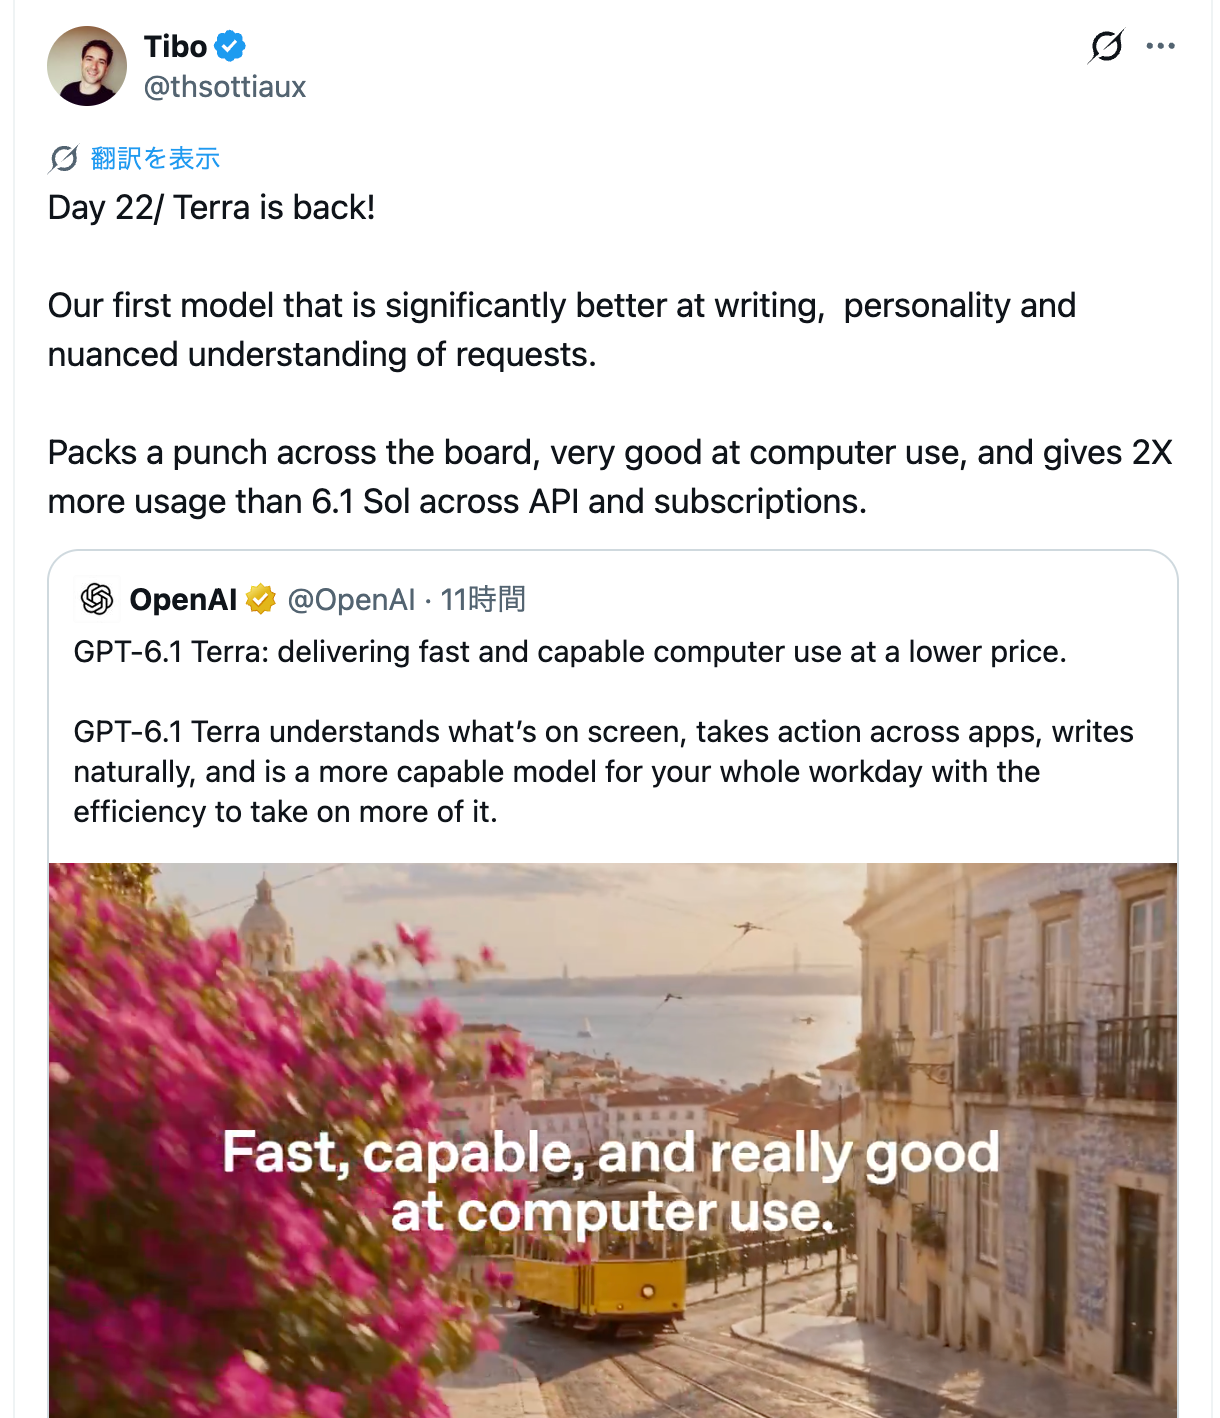
画像内の日本語訳(本投稿・引用投稿・動画内字幕の全文)
Tibo氏・本投稿
DAY22/Terraが帰ってきました!
文章の作成、応答の個性、依頼の細かなニュアンスの理解で、大幅に優れた性能を示す、私たちにとって初めてのモデルです。
幅広い分野で力を発揮し、コンピューター操作がとても得意です。APIとサブスクリプションの両方で、6.1 Solと比べて2倍使えます。
引用されているOpenAIの投稿
GPT-6.1 Terra:高速で高性能なコンピューター操作を、より低価格で。
GPT-6.1 Terraは、画面に何が表示されているかを理解し、アプリをまたいで操作し、自然な文章を書きます。一日を通した仕事に使える、さらに高性能なモデルで、その効率のよさによって、より多くの仕事を引き受けられます。
動画内に見える字幕
速く、高性能で、コンピューター操作がとても得意。
出典:Tibo氏のDAY22の投稿/引用されているOpenAIの発表投稿。画像には動画の一場面が表示されています。
DAY22は、新モデルGPT-6.1 Terraの登場です。Tibo氏は、文章の書き方や依頼のニュアンスをつかむ力、コンピューター操作、利用量を挙げています。
ここでいうコンピューター操作は、画面を見て説明するだけでなく、目的に沿ってアプリを使い、作業を進める能力です。たとえば、商品写真と一覧の対応を確認し、必要な情報を整理する、といった仕事につながります。公式の週次更新
日々の仕事には、「すごく難しい問題を一度だけ解く」だけでなく、資料を読み、画面を確認し、文章を整え、決まった場所へ入力する作業もあります。その繰り返しを、待ち時間や費用を抑えて任せやすくすることが、Terraの価値を考える入り口になりそうです。
ただし、投稿の「文章やニュアンス理解で優れている」という表現だけから、Solを含む全モデルより日本語の文章力が上だとまでは言えません。「2倍使える」という説明も、どんな作業でも完成件数が必ず2倍になる保証として読むのではなく、後で料金と利用枠を分けて確認します。
公式グラフは何を表している? まずは縦軸と横軸を確認
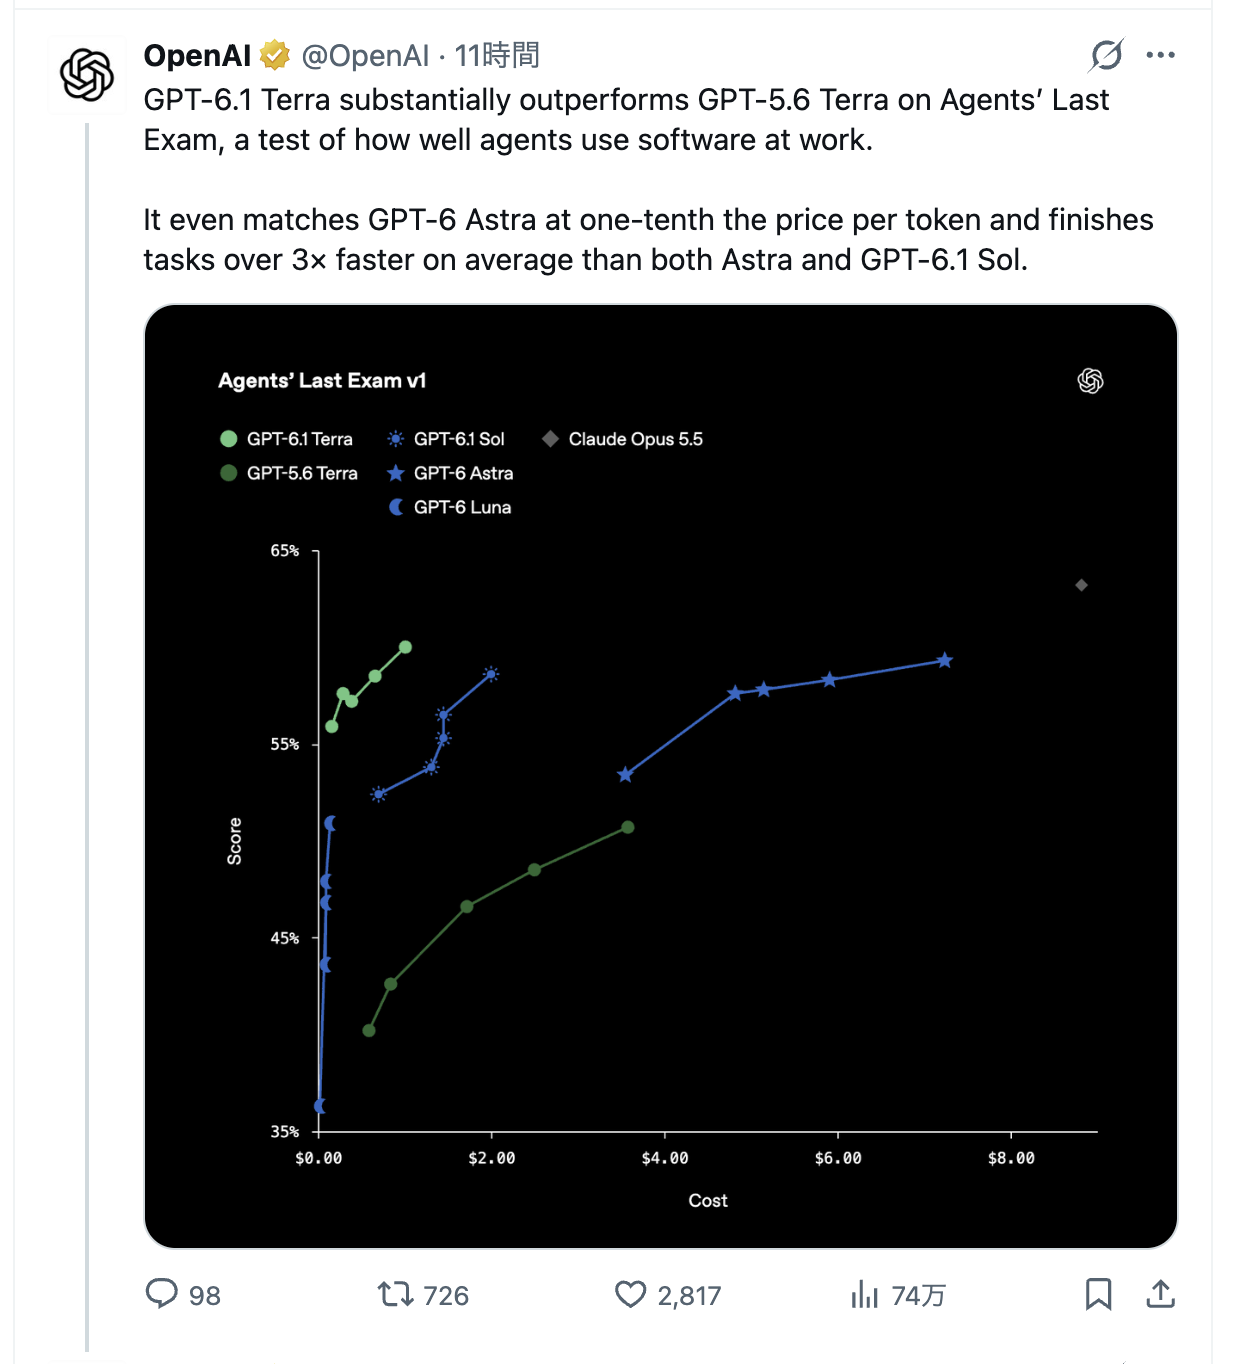
画像内の日本語訳(投稿全文・グラフ内の表記)
OpenAIの投稿
GPT-6.1 Terraは、エージェントが仕事でソフトウェアをどれほど上手に使えるかを測るテスト「Agents’ Last Exam」で、GPT-5.6 Terraを大幅に上回っています。
トークン単価がGPT-6 Astraの10分の1でありながら、同等の成績を上げています。さらに、AstraとGPT-6.1 Solの両方と比べ、平均で3倍超の速さでタスクを完了します。
グラフ内の表記
Agents’ Last Exam v1:Agents’ Last Exam 第1版。
Score:スコア。Cost:費用。
凡例:GPT-6.1 Terra、GPT-5.6 Terra、GPT-6.1 Sol、GPT-6 Astra、GPT-6 Luna、Claude Opus 5.5。
縦軸の目盛り:35%、45%、55%、65%。
横軸の目盛り:0.00ドル、2.00ドル、4.00ドル、6.00ドル、8.00ドル。
出典:OpenAIのAgents’ Last Examの投稿。モデルの測定結果はOpenAIが公表したものです。
今回いちばん引っかかるのが、このグラフです。上にあるほど良い成績、左にあるほど低い費用。まずその読み方は合っています。ただ、何の成績なのか、何に対する費用なのかを押さえると、モデル全体の順位表とは違うことが分かります。
縦軸は「部分点を含むスコア」。仕事の完全成功率とは違う
Agents’ Last Exam(ALE)は、ソフトウェアを使う専門的な仕事で、要求に沿った結果をどこまで出せるかを評価するベンチマークです。共同提供元の説明では、次の2つを分けています。ALE v1の評価方法
| 指標 | 意味 |
|---|---|
| Score | 部分点も含めた、全課題の採点結果の平均 |
| Pass Rate | 完全な成功条件を満たした課題の割合 |
このグラフが使っているのは、上のScoreです。したがって、約60%という位置を見て「6割の仕事を最後まで完全自動化できる」と言い換えることはできません。
違いをイメージするなら、「必要な資料は集められたが、最終成果物の条件を一部満たせなかった仕事」を考えると分かりやすいでしょう。途中までできたことに点を与える評価と、完成条件をすべて満たしたかを見る評価では、同じ作業でも数字が変わります。これは説明のための例で、特定のTerraの実行結果ではありません。
また、この種の試験では、モデルに加えてツールや作業を進める仕組みも関わります。チャット欄へ一問だけ投げたときの知識量を、そのまま測った数字ではありません。ALEの説明
横軸は「作業にかかる費用」。トークン単価表ではない
横軸は、ベンチマークの課題を実行する費用を示しています。公式記事も、この比較を説明する際に「タスク当たりの費用」を使っています。後で紹介する「100万トークン当たり1ドル」とは、単位が違います。公式発表
トークン単価は、AIが読み書きする情報量に対する単価です。タスクの費用は、それに加えて、その仕事で実際にどれだけ情報を読み、考え、出力し、何度処理を行ったかに左右されます。
そのため、Astraに対してトークン単価が10分の1でも、あらゆる仕事の総費用が10分の1になるわけではありません。 図の費用も、「必ず完成品を1件得るための費用」と読むものではなく、実務の確認・手直しにかかる時間は別に見ておく必要があります。
なお、この図の横軸は0・2・4・6・8ドルが等間隔の線形目盛です。縦軸は35%から始まるため、線の上下の差を見た印象と、実際の点差は分けて読んだほうがよいでしょう。
Terraは左上。ただし、図の最高点はClaude Opus 5.5
画像の位置関係を、おおよその値で整理すると次のようになります。
| モデル | 図中の最も高い点のスコア | その点の費用の位置 |
|---|---|---|
| GPT-6.1 Terra | 約60% | 約1ドル |
| GPT-6.1 Sol | 約59% | 約2ドル |
| GPT-6 Astra | 約59% | 約7ドル |
| Claude Opus 5.5 | 約63% | 約9ドル |
上表はこのグラフを目視した概数です。小数点付きの原データを再現した表ではありません。 各行は、そのモデルで図に示された最高点を拾ったもので、推論設定や予算を揃えた表とも区別してください。
Terraの見どころは、Solより高いスコアの点を、より低い費用側で出していることです。一方、費用を多く使ってでもこの試験の最高スコアを求めるなら、図ではClaude Opus 5.5が上にいます。「最高点」と「費用に対して得られる成績」は、同じ問いではありません。
ここから「ClaudeよりTerraのほうが常に優れている」「逆にClaudeだけ選べばよい」とも決められません。数点の差が必要な仕事もあれば、十分な品質を低い費用で何度も得られることが大事な仕事もあります。なお、Geminiはこの図に載っていないため、この画像からGeminiとの上下関係は判断できません。
小さな点差や「3倍速」を、すべての使い方へ広げない
この静止画には、各点がどの推論設定に対応するかを示すラベルや、測定のばらつきを示す誤差棒はありません。公式記事にはmediumやmaxの条件が登場しますが、画像の点へ左から順番に設定名を割り振ることは避けたいところです。
同様に、約1〜2ポイントの差だけから、どんな仕事でも安定してTerraが勝つ、統計的にも確実に優れている、とまでは言えません。この図はALEのv1です。別の版や別の実行環境の結果を、そのまま同じ列へ足すこともできません。ALE v1
「平均で3倍超速い」という説明も、今回の評価でのタスク完了についてOpenAIが述べたものです。すべての質問への返答、文章の出る速さ、他社モデルとの速度差まで一括して3倍になる、という意味ではありません。発表投稿
それでもSolのほうが賢い? 評価を変えると順位も変わる
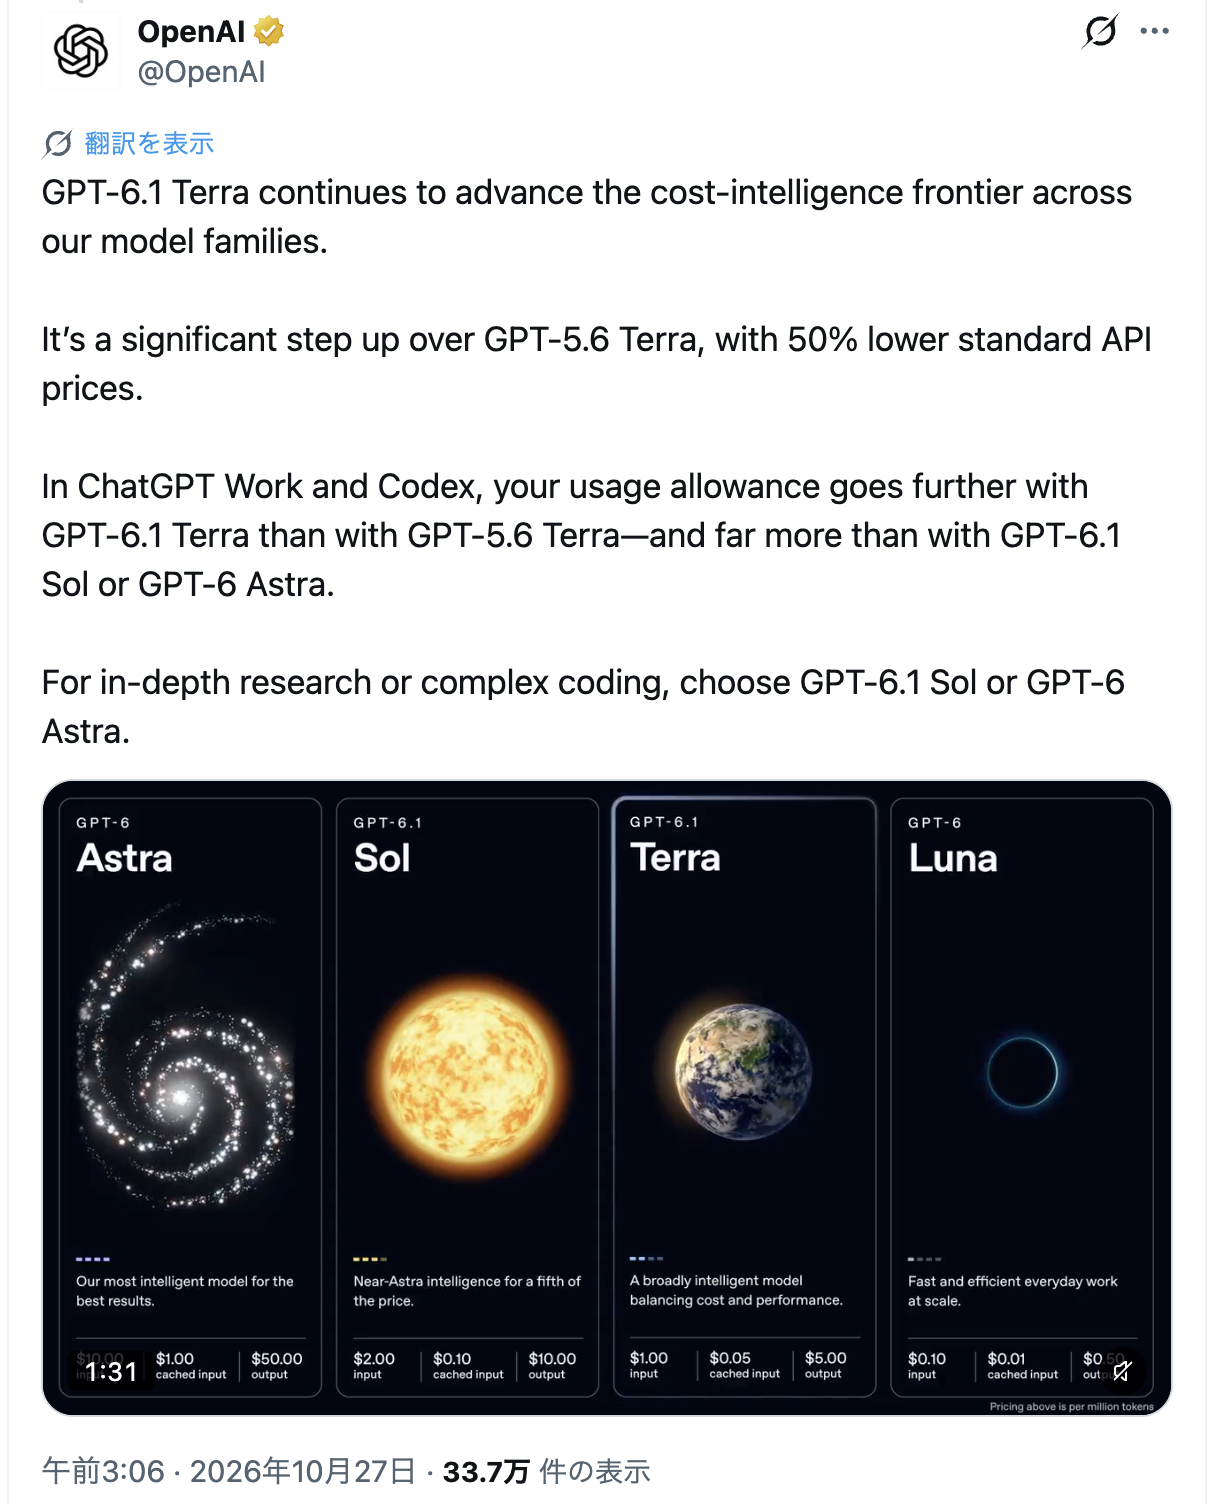
画像内の日本語訳(投稿全文・モデル紹介・料金表示)
OpenAIの投稿
GPT-6.1 Terraは、私たちのモデル群における、費用と知性の両立の水準をさらに高めています。
GPT-5.6 Terraから大きく進歩し、標準API料金は50%低くなっています。
ChatGPT WorkとCodexでは、GPT-6.1 Terraを使うと、GPT-5.6 Terraよりも同じ利用枠で多く使えます。GPT-6.1 SolやGPT-6 Astraと比べると、その差はさらに大きくなります。
深い調査や複雑なコーディングには、GPT-6.1 SolまたはGPT-6 Astraを選んでください。
画像内のモデル紹介
GPT-6 Astra:最高の成果のための、私たちの最も知的なモデル。
GPT-6.1 Sol:Astraの5分の1の価格で、Astraに迫る知性。
GPT-6.1 Terra:費用と性能のバランスを取った、幅広い知性を備えるモデル。
GPT-6 Luna:大規模な日常業務を、速く効率的に。
画像内の料金表示
Input=入力、Cached input=キャッシュ済み入力、Output=出力。
GPT-6 Astra:入力10.00ドル、キャッシュ済み入力1.00ドル、出力50.00ドル。
GPT-6.1 Sol:入力2.00ドル、キャッシュ済み入力0.10ドル、出力10.00ドル。
GPT-6.1 Terra:入力1.00ドル、キャッシュ済み入力0.05ドル、出力5.00ドル。
GPT-6 Luna:入力0.10ドル、キャッシュ済み入力0.01ドル、出力0.50ドル。
上記の料金は100万トークン当たりです。
出典:OpenAIの価格とモデルの使い分けに関する投稿。動画の操作表示がカードの一部に重なっているため、料金の数値はAPI料金資料とも照合しています。
「このグラフは特定の指標だと分かった。それでも、全体としてはSolのほうが賢いの?」という疑問は残ります。ここは、公式の用途案内と、別の評価結果を合わせて見ると、かなり整理できます。
公式は、深い調査や複雑なコーディングにSol/Astraを案内
OpenAIの別の投稿には、モデルの位置づけがはっきり書かれています。Terraの性能と低価格を紹介しながら、最後にはSol/Astraを選ぶ場面も示しています。
公式のモデル選択ガイドでも、Terraは資料に基づく文章や目的の定まった画面操作、範囲の限られたコード修正に挙げられています。Solは、時間と費用を管理しながら取り組む複雑な仕事の選択肢です。モデル選択ガイド
この案内から言えるのは、Terraが登場しても、Solを選ぶ理由は残っているということです。ただし、それを「Solはすべての作業でTerraより上」と言い換えると、今見たグラフの結果を無視してしまいます。
独立評価ではSolが上。ただし、その指数にも対象範囲がある
メーカーの発表だけでなく、Artificial Analysis自身が公開する評価も確認しました。2026年10月27日確認時点のIntelligence Index v4.3.2では、次の値でした。
| モデルと推論設定 | Artificial Analysis Intelligence Index |
|---|---|
| GPT-6.1 Terra・Max | 48 |
| GPT-6.1 Sol・Max | 52 |
出典:Artificial AnalysisのTerra評価/Sol評価。48・52は指数の値で、正答率48%・52%という意味ではありません。
この指数は10種類の評価を組み合わせたもので、主に英語のテキスト課題を対象にしています。画像や多言語の能力は別に評価されるため、これも日本語の文章力や、あらゆる画面操作を一括して決める万能な順位ではありません。同社の評価方法
それでも、「TerraがSolを全面的に上回った」とは言えないことを裏づける材料になります。ALEではTerraが良く見え、別の幅広い課題をまとめた指数ではSolが上に来る。得意な仕事と、測定方法が違えば、順位が変わるということです。
Terraが上回るのは、ALEの一項目だけとも限らない
逆に、「Terraが勝つのは、たまたまこのグラフだけ」と決めるのも早計です。OpenAIは、科学研究に関わるコード実行を評価するTerminal-Bench-Science 0.1でも、max設定のTerraがSolを低コストで上回ったと説明しています。公式発表
一方、一般のターミナル作業を扱うTerminal-Bench 4.0では、Terraの最大設定の課題解決率は50.3%。旧Terraの公表値21.5%から改善したものの、公式は最も複雑なコーディングにはSol/Astraを勧めています。公式発表
ベンチマーク名に同じ「Terminal」が入っていても、対象の仕事は異なります。「コードを書く仕事だからすべてSol」「PCを使う仕事だからすべてTerra」と分けるより、どの部分が難しい仕事なのかを見るほうが役立ちます。
安いモデルが一部で勝っても、矛盾ではない
モデルの価格は、あらゆる能力を一本の物差しに並べた点数表ではありません。文章を整える力、画像の細部を読む力、長い作業の途中で判断を保つ力、曖昧な条件を整理する力は、それぞれ違います。
ある仕事に必要な能力がTerraの得意分野と合えば、低い費用で良い結果が出ることはあり得ます。複数の能力をまたぐ難しい仕事では、SolやAstraを選ぶ意味が残ります。今回の結果を説明するために、公開されていないモデルの大きさや学習方法まで推測する必要はありません。
私なら現時点では、複雑な調査や開発には引き続きSol/Astraを候補にしつつ、画面を使う作業や資料に沿った文章では、Terraを実際に比べてみるという受け止め方をします。これは今回の資料から考えた選び方で、筆者がTerraとSolを同条件で実測した結果ではありません。
安さはどのくらい? API単価と利用枠を混同しない
価格の話では、「トークンの単価」「1件の仕事にかかる費用」「月額プランで使える量」の3つを分けると、理解しやすくなります。発表の中では、これらが近い場所に出てくるので、同じ数字として読まないことが大切です。
GPT-6.1 Solと比べると、標準のトークン単価は半額
まずは、開発者がAPIで使う場合の標準単価です。入力はAIへ渡す情報、出力はAIが生成する情報、キャッシュ済み入力は再利用できる入力部分に対応します。
| モデル | 入力 | キャッシュ済み入力の読み取り | 出力 |
|---|---|---|---|
| GPT-6.1 Terra | $1.00 | $0.05 | $5.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
単位は米ドル/100万トークン。Standardで、長文に対する追加倍率などを適用しない通常単価です。出典:Terra/Sol/Astra/Lunaの公式モデル資料。
TerraはSolに対し、表の3区分とも半額です。ここは明確に安くなっています。ただし、Terraは最も安いモデルではなく、定型処理向けのLunaにはさらに低い単価があります。
たとえば、キャッシュを使わず入力10万トークン、課金対象の出力1万トークンを同じだけ処理すると仮定すると、表の単価だけによる計算は次のとおりです。
- Terra:0.1 × 1ドル + 0.01 × 5ドル = 0.15ドル。
- Sol:0.1 × 2ドル + 0.01 × 10ドル = 0.30ドル。
これは料金の仕組みを示す仮定の計算で、実際の仕事を比較した測定値ではありません。両モデルが同じ情報量・同じ回数で完成させるとは限らず、推論に使うトークン、キャッシュの書き込み、ツールなどの条件も実際の請求に関わります。API料金表の出力単価は、画面に表示される文章の分だけを数えればよい、という意味ではありません。API料金表
なお、発表には旧GPT-5.6 Terra比で「標準API料金が50%低い」という説明もあります。現在の個別料金表を項目ごとに見ると、旧Terraは入力2ドル・キャッシュ読取0.20ドル・出力12ドルなので、新Terraへの低下率はそれぞれ50%・75%・約58%です。「どの項目も、どの比較相手でも、きっちり半額」とまとめないほうが正確です。旧Terraの料金・新Terraの料金
「2倍使える」は、質問の回数が必ず2倍になるという意味ではない
APIとは別に、ChatGPT Work/Codexではプランの利用枠やCreditsという仕組みがあります。現行のStandardのCredits表でも、Terraの入力・キャッシュ読取・出力は、Solの半分の単価です。Work/Codexの料金資料
| 100万トークン当たり・Standard | 入力 | キャッシュ読取 | 出力 |
|---|---|---|---|
| GPT-6.1 Terra | 25 credits | 1.25 credits | 125 credits |
| GPT-6.1 Sol | 50 credits | 2.5 credits | 250 credits |
ただし、公式はCredits単価だけではプランに含まれる利用量は決まらないとも説明しています。長い資料を読む仕事、深く考える仕事、ツールを何度も使う仕事では、同じ1メッセージでも消費が違います。WorkとCodexは利用枠を共有し、今回、プラン全体の上限そのものが一律に引き上げられたわけでもありません。Work/Codexの料金資料
そのため、「月額料金が半額になる」「何を頼んでも質問回数が2倍になる」と読むのは違います。同じ予算や利用枠の中で、より多くの作業を進められる選択肢が増えたと考えると、実際の使い方につながります。
どの仕事ならTerraが活躍する? 選び方を具体化する
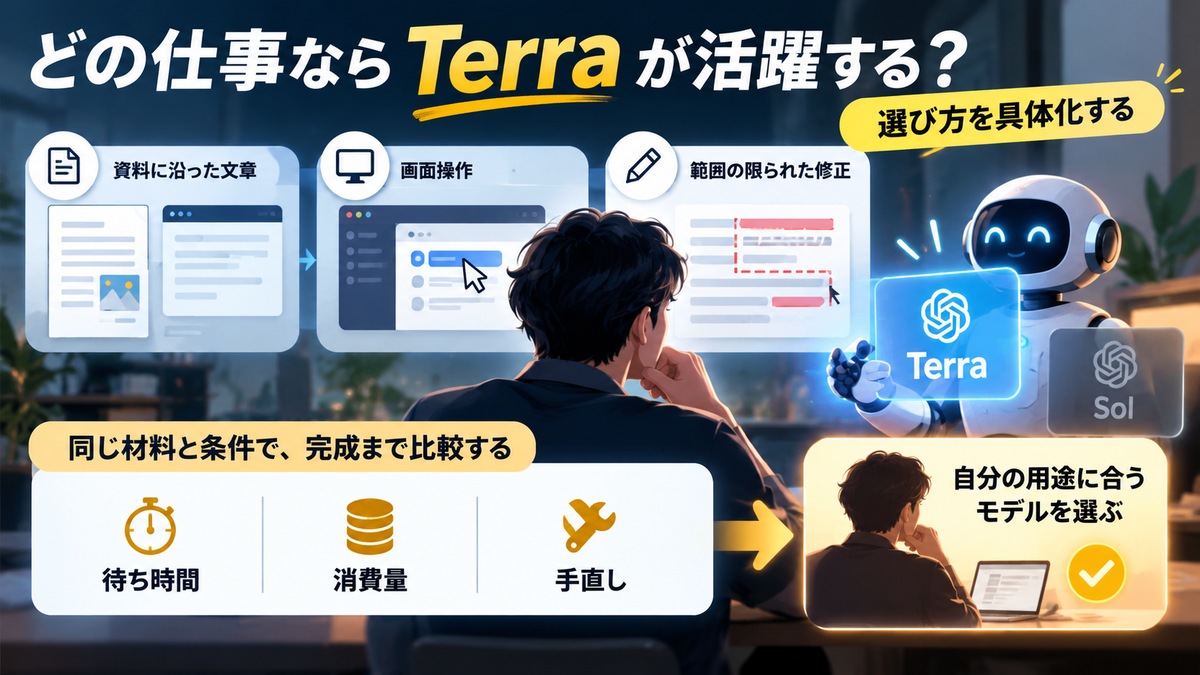
ベンチマークを理解したら、次は自分の仕事です。公式の用途案内を出発点に、日々の作業へ置き換えてみます。以下は活用案であり、筆者の実測による優劣の一覧ではありません。
文章・画面・小さな修正から試すと、違いを見つけやすい
| 仕事の例 | 最初に試す候補 | 比較するときに見たい点 |
|---|---|---|
| 手元の資料をもとに、案内文や提案文を整える | Terra | 必要な事実を残し、読み手に合った自然な文章になっているか |
| 商品写真と一覧を照合し、登録情報を整理する | Terra | 対応関係を取り違えず、実際の保存結果まで正しいか |
| 画面上の内容を確認し、条件の決まった入力作業を進める | Terra | 入力値や保存先、完了報告が実際の結果と一致するか |
| 変更箇所が限定されたコードを修正する | Terraを試し、必要に応じてSol | 指示した修正ができ、関連する動作も保たれるか |
| 複数の資料の矛盾を整理し、難しい実装方針を決める | Sol/Astra | 条件の見落としや、後で手戻りになる判断がないか |
| 決まった項目の抽出・分類・整形を大量に繰り返す | Lunaも候補 | 必要な品質に対して、Terraまで使う意味があるか |
モデルの役割は公式モデル選択ガイドとWork/Codexのモデル案内を参照し、比較観点はこの記事の用途に合わせて具体化しています。
たとえば記事制作なら、調査方針を立て、異なる資料の食い違いを確かめる段階と、確認済みの内容を読みやすく整える段階では、難しさの種類が違います。後半の作業にTerraが合う可能性はありますが、短く整った文章になっただけで、内容まで正しくなったとは判断できません。出典・数値・条件が残っているかまで見て選びたいところです。
「日常のPC作業に強い」という捉え方は、今回の方向性をつかむうえで役立ちます。一方で、PC操作専用で、文章やコードには使えないモデルとまで狭める必要はありません。公式は文章や限定的なコード修正も用途に挙げており、先ほどの科学研究の試験でも強みを示しています。
いつもMaxにするべき? 公式は必要に応じて上げる方針
最大の推論設定で良い成績が出ると、「TerraはMaxで使わないと意味がないのでは」と考えたくなるかもしれません。しかし、常にMaxというのが公式の推奨ではありません。
OpenAIはTerraのAPI利用について、まずmediumから始め、追加の時間やトークンに見合う品質改善がある場合に設定を上げるよう案内しています。Work/Codexの案内も、既定の設定から始め、必要に応じて深く考えさせる方針です。両者を混ぜて、すべてのアプリでmediumが既定だと決めつける必要はありません。APIのTerra利用ガイド・Work/Codexの推論設定
軽い文章の整形と、何度も判断を伴う画面操作では、必要な考える量も違います。Maxにしたときの品質改善が、待ち時間や利用量の増加に見合うかを、自分の仕事で確かめるのがよさそうです。
事実誤認についても、公式の社内評価で改善は報告されています。ただ、その数字は誤りを誘発する特定の課題群での結果です。「Maxなら間違えない」「低い設定なら日常業務でも一定の確率で失敗する」といった、個々の利用への直接換算はできません。公式発表
比べるなら「同じ材料で、完成まで」を見る
私なら、まず繰り返し行う仕事をひとつ選び、次の順で比較します。
- 完成条件を決める。 たとえば「3つの必須事項を残した案内文」「指定した10件の入力が保存済み」など、終わりを判断できる形にする。
- 同じ資料と指示を渡す。 比較用には別の会話を用意し、一方だけに有利な追加説明を入れない。
- 最初は推論設定を揃える。 モデル差と設定差を、一度に混ぜない。
- 結果・待ち時間・消費量・手直しを記録する。 最初の回答が速いだけでなく、使える状態まで何分かかったかを見る。
- 別の代表的な仕事でも試す。 一度の当たり外れを、モデル全体の性質にしない。
これは自分の用途を見つけるための比較案です。正式な性能試験ではありませんが、「何となく賢く感じた」だけより、次にどちらを使うか判断しやすくなります。
計算の例として、同じ仕事への1回の試行がTerraで0.15ドル、Solで0.30ドルだったとします。もしTerraでは合計3回の試行が必要で、Solは1回で終わるなら、前者は0.45ドルです。逆に両方1回で十分ならTerraの安さがそのまま活きます。これは失敗率の予測ではなく、単価と完成までの負担が違うことを示す仮定です。
どこで使える? ChatGPT Work・Codex・APIの提供条件
画像内の日本語訳(投稿全文・リンクカード内の表記)
OpenAIの投稿
GPT-6.1 Terraは現在、順次提供を開始しています。ChatGPT WorkとCodexを使うPlus、Pro、Enterprise、Eduのすべてのユーザーが利用できます。
開発者は、OpenAI APIでも
gpt-6.1-terraとして利用できます。画像・リンクカード内の表記
GPT-6.1 Terra
GPT-6.1 Terraのご紹介
出典:OpenAIの提供開始の投稿。
提供先も確認しておきます。発表ではChatGPT Work、Codex、APIが案内されています。「ChatGPT」という名前だけを見て、通常のチャット画面に同じモデルが必ず出る、と考えると迷う部分です。
画像の投稿には4プランが挙げられていますが、10月27日に確認した公式の週次更新では、Plus・Pro・Business・Enterprise・Eduが対象です。Workはデスクトップ、Web、モバイルで対応し、通常のChatには提供されません。Enterpriseではワークスペースや管理者の設定にもよります。公式の週次更新
デスクトップ/Webでは、Advancedのモデル一覧からTerraを選ぶ案内があります。画面を操作する機能には、それぞれの接続・利用条件もあるため、モデルを選べたことと、すべてのアプリを操作できることは分けて確認しましょう。公式の週次更新
APIで使う場合のモデルIDは gpt-6.1-terra です。Codex CLIから使う場合は、公式モデル案内で0.159.0以降が必要とされています。公式モデル資料・Work/Codexのモデル案内
これまでの改善とつなぐと、DAY22の意味が見えてくる
連載を振り返ると、ここしばらくは、AIの回答そのものに加えて「長い仕事を続けやすくする」改善が積み重なってきました。今回のTerraは、そこへモデル自体の費用と性能の選択肢を加える更新と捉えられます。
| 日 | 取り上げた改善 | 今回のモデル選びにつながる視点 |
|---|---|---|
| DAY7 | Codex/WorkでのGPT-6.1 Solの標準コンテキスト長を500kへ拡大 | 長い背景情報を扱う余地 |
| DAY12 | サブエージェント間の文脈再利用、キャッシュ保持、処理の振り分けを改善 | 同じ情報を何度も処理する負担を減らす |
| DAY16 | 時間を空けて会話へ戻る場面のキャッシュ保持を改善 | 中断後も続きに取りかかりやすくする |
| DAY19 | 会話途中で推論設定を変えても、キャッシュを無効にしない | 同じモデルで、仕事の難しさに合わせて考える量を選ぶ |
| DAY22 | GPT-6.1 Terraを追加 | 仕事に合うモデルと、費用・時間のバランスを選ぶ |
右列は、この連載を通した筆者の整理です。DAY7の500kは当時のSolの製品上の標準値で、Terraの仕様やAPIの最大値へそのまま流用するものではありません。
ここで一つ、前回から引き継ぎたい点があります。同じモデルの推論設定を変えることと、SolからTerraへモデルを切り替えることは別です。 DAY19の改善を根拠に、モデルを変えてもキャッシュがそのまま保たれる、とまでは言えません。前回の記事
利用枠を戻すリセットと、1件の仕事で使う量を減らす改善も別のものです。DAY20・21で枠が戻ることは、その時点で続きを進める助けになります。DAY22のように、条件に合う仕事を少ない費用で任せられる選択肢が増えることは、その後の使い方を変える可能性があります。過去の改善率と今回の低価格を掛け合わせて「何倍使える」とはせず、それぞれが効く場面を見ていきたいところです。
週末の周辺投稿も記録。外観設定とdotsへの呼びかけ
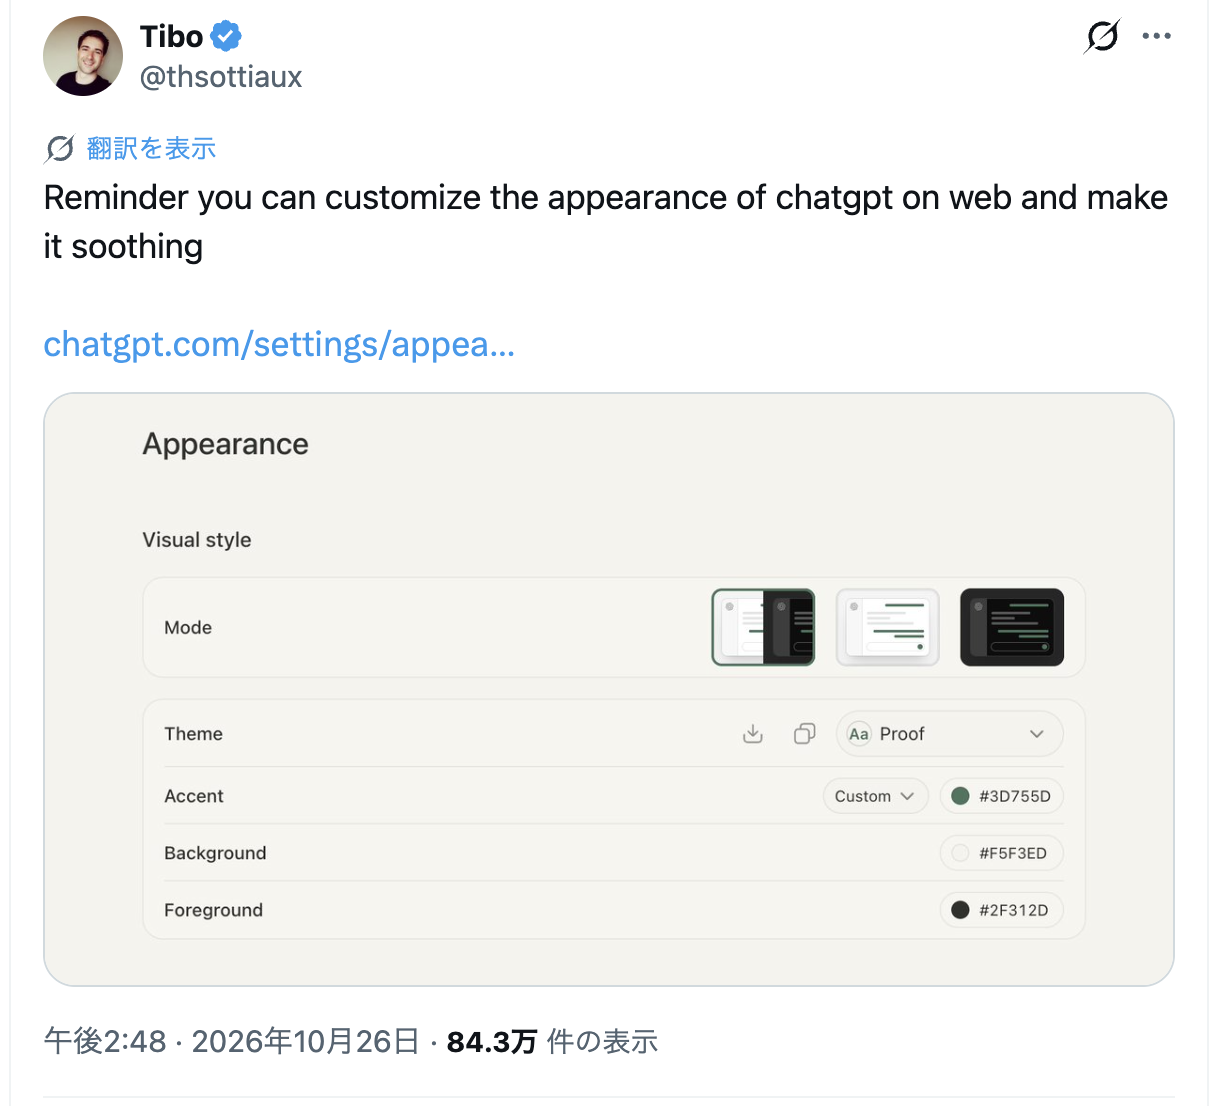
画像内の日本語訳(投稿全文・設定画面の表記)
Tibo氏の投稿
あらためてお知らせします。Web版ChatGPTの外観はカスタマイズでき、落ち着いた雰囲気にできます。
設定画面の表記
Appearance:外観。
Visual style:表示スタイル。
Mode:モード。
Theme:テーマ。Proof:テーマ名のため、そのまま表記。
Accent:アクセントカラー。Custom:カスタム。表示されている値は
#3D755D。Background:背景。表示されている値は
#F5F3ED。Foreground:前景。表示されている値は
#2F312D。
出典:Tibo氏の外観カスタマイズの投稿。投稿内の設定URLは画像で省略表示されているため、ここでは投稿自体へリンクしています。
同じ時期には、モデルやリセット以外の投稿もありました。28日間企画の改善内容とは区別しながら、週末の動きも見ておきます。
Web版ChatGPTの外観は、落ち着いた雰囲気にもできる
Tibo氏は、Web版ChatGPTの外観を変えられることも再案内しています。
原文は「あらためてお知らせ」という書き方です。この日に初めて追加された機能という発表ではありません。長く使う作業画面を、自分にとって見やすい雰囲気へ整える話として受け止められます。
dotsの規模拡大に向けた呼びかけと、週末の開発
別の画像には、dotsへの協力を求める投稿や、週末の過ごし方についての投稿がまとまっています。
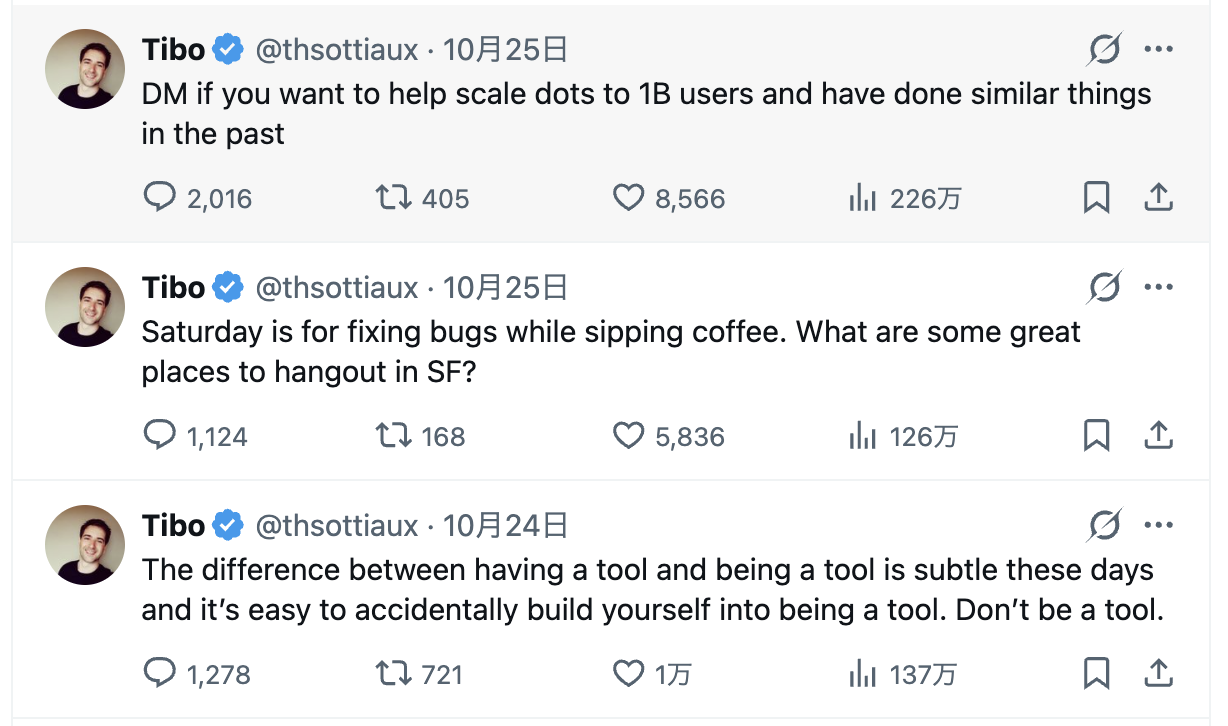
画像内の日本語訳(3投稿の全文)
上段の投稿
dotsを10億人のユーザーに対応できる規模へ広げることに協力したい方で、過去に同様の経験がある方は、DMをください。
中段の投稿
土曜日は、コーヒーを飲みながらバグを直す日です。サンフランシスコで、ゆっくり過ごせる良い場所はありますか?
下段の投稿
道具を持つことと、自分が道具になることの違いは、最近では微妙です。気づかないうちに、自分自身を道具のような存在にしてしまうのも簡単です。道具にはならないでください。
出典:Tibo氏のdotsに関する呼びかけ/土曜日の投稿/道具についての投稿。下段は英語の「tool」を使った言葉遊びを含み、技術機能を説明する文章ではありません。
上段の「10億人」は、そこまで規模を広げることへの呼びかけです。dotsの現在の利用者数が10億人になったという発表ではありません。 また、週末にバグ修正の話があっても、それをDAY20・21の正式な改善項目へ数え足すことはしません。
まとめ|モデルの値段だけでなく、任せる仕事から選ぶ
DAY20・21はリセット、DAY22はGPT-6.1 Terraの登場でした。今回のグラフでTerraがSolより良く見えることには、きちんと根拠があります。ただし、その得点は仕事でソフトウェアを使う評価のもので、部分点を含みます。
記事を通して押さえたいのは、次の4点です。
- 特定の評価では、TerraがSolより低い費用で高いスコアを出している。 安いモデルが一部の仕事で上回ること自体は、矛盾ではありません。
- 深い調査や複雑な開発には、引き続きSol/Astraを選ぶ理由がある。 独立評価の複合指数でも、SolがTerraを上回っています。
- トークン単価の半額と、仕事全体の費用や質問回数の半分・2倍は別。 手直しまで含めた負担で比べたいところです。
- TerraをいつもMaxにする必要はない。 普段の仕事で、必要な品質と待ち時間・利用量のバランスを確かめて選べます。
「Solのほうが常に賢い」と決めつける必要も、「Terraが全部置き換えた」と急いで切り替える必要もありません。まずは、よく頼む仕事をひとつ、同じ材料で比べてみる。文章を整える、画面上の情報を確認する、範囲の決まった修正をする。そのどこでTerraの安さと速さが活きるのかを、自分の作業で見つけていくのがよさそうです。
出典・参考資料
情報確認日:2026年10月27日(日本時間)。公式の発表、評価を実施した機関の資料、公開済みの連載記事を参照しています。掲載したスクリーンショットの英語部分は、各画像の直後に全訳を掲載しました。
DAY20・DAY21・DAY22と関連投稿
- Tibo:DAY20/期限の返信/反映完了の続報/DAY21/DAY22。
- OpenAI:Terraの告知/価格とモデルの使い分け/ALEのグラフ/提供開始。
- Tibo:Web版ChatGPTの外観/dotsの規模拡大への呼びかけ/週末のバグ修正/道具についての投稿。
モデル・料金・使い方
- OpenAI:Introducing GPT-6.1 Terra。
- OpenAI:GPT-6.1 Terra/GPT-6.1 Sol/GPT-6 Astra/GPT-6 Luna/GPT-5.6 TerraのAPIモデル資料。
- OpenAI:API料金表/Work・Codexの料金と利用枠。
- OpenAI:モデル選択ガイド/GPT-6の利用ガイド/Work・Codexのモデル案内。
- OpenAI:2026年10月26〜30日の公式更新。
ベンチマークと独立評価
- Snorkel AI:Agents’ Last Exam v1の評価・方法論。ScoreとPass Rateの定義を確認。
- Artificial Analysis:GPT-6.1 Terra/GPT-6.1 Sol。Max設定とIntelligence Index v4.3.2の値を確認。
- Artificial Analysis:Intelligence Benchmarking Methodology。指数の対象・構成・限界を確認。
コメント